体系结构设计优化 & Triton: GPU编程的新范式
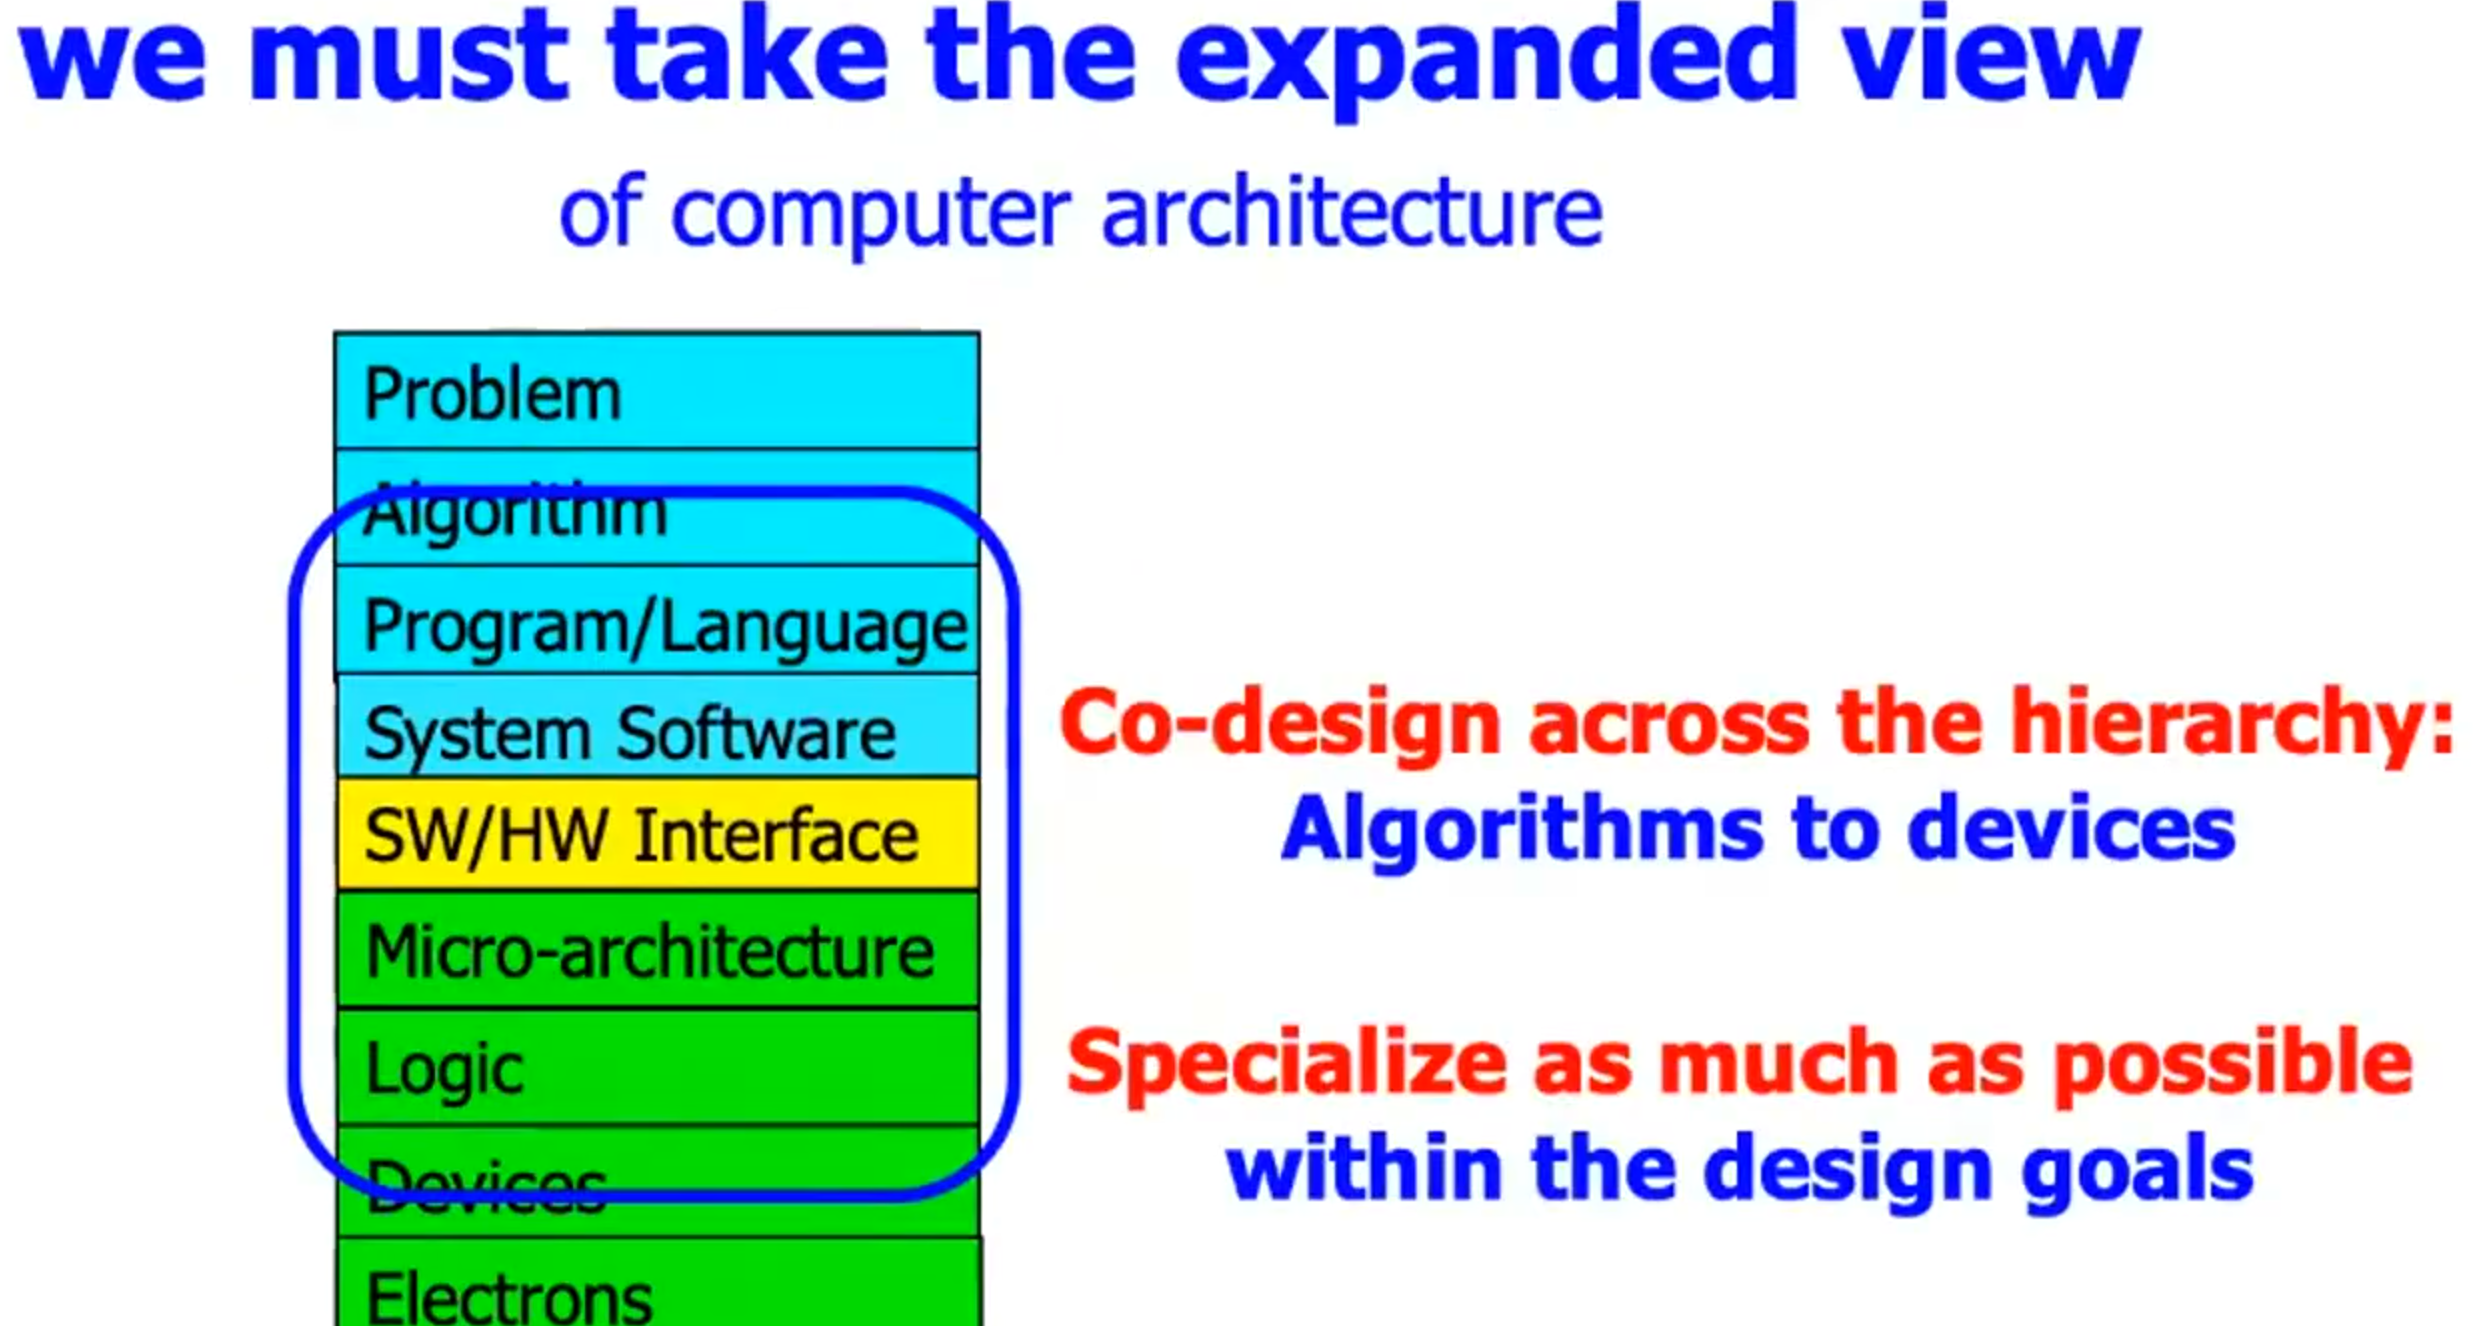 计算机体系结构的范围很大,可以认为包括了算法到电路之间的所有软硬件设计。
以GPGPU为例,统一需要底层计算单元硬件-控制模块-指令与编译器支持-前端的软件设计。
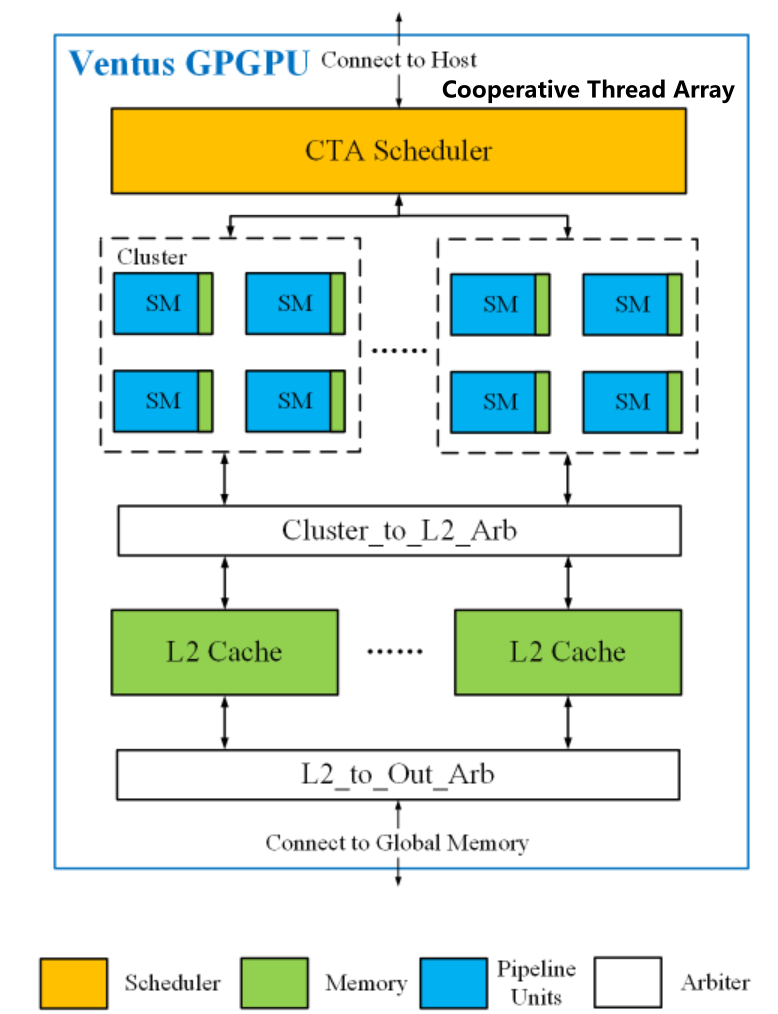
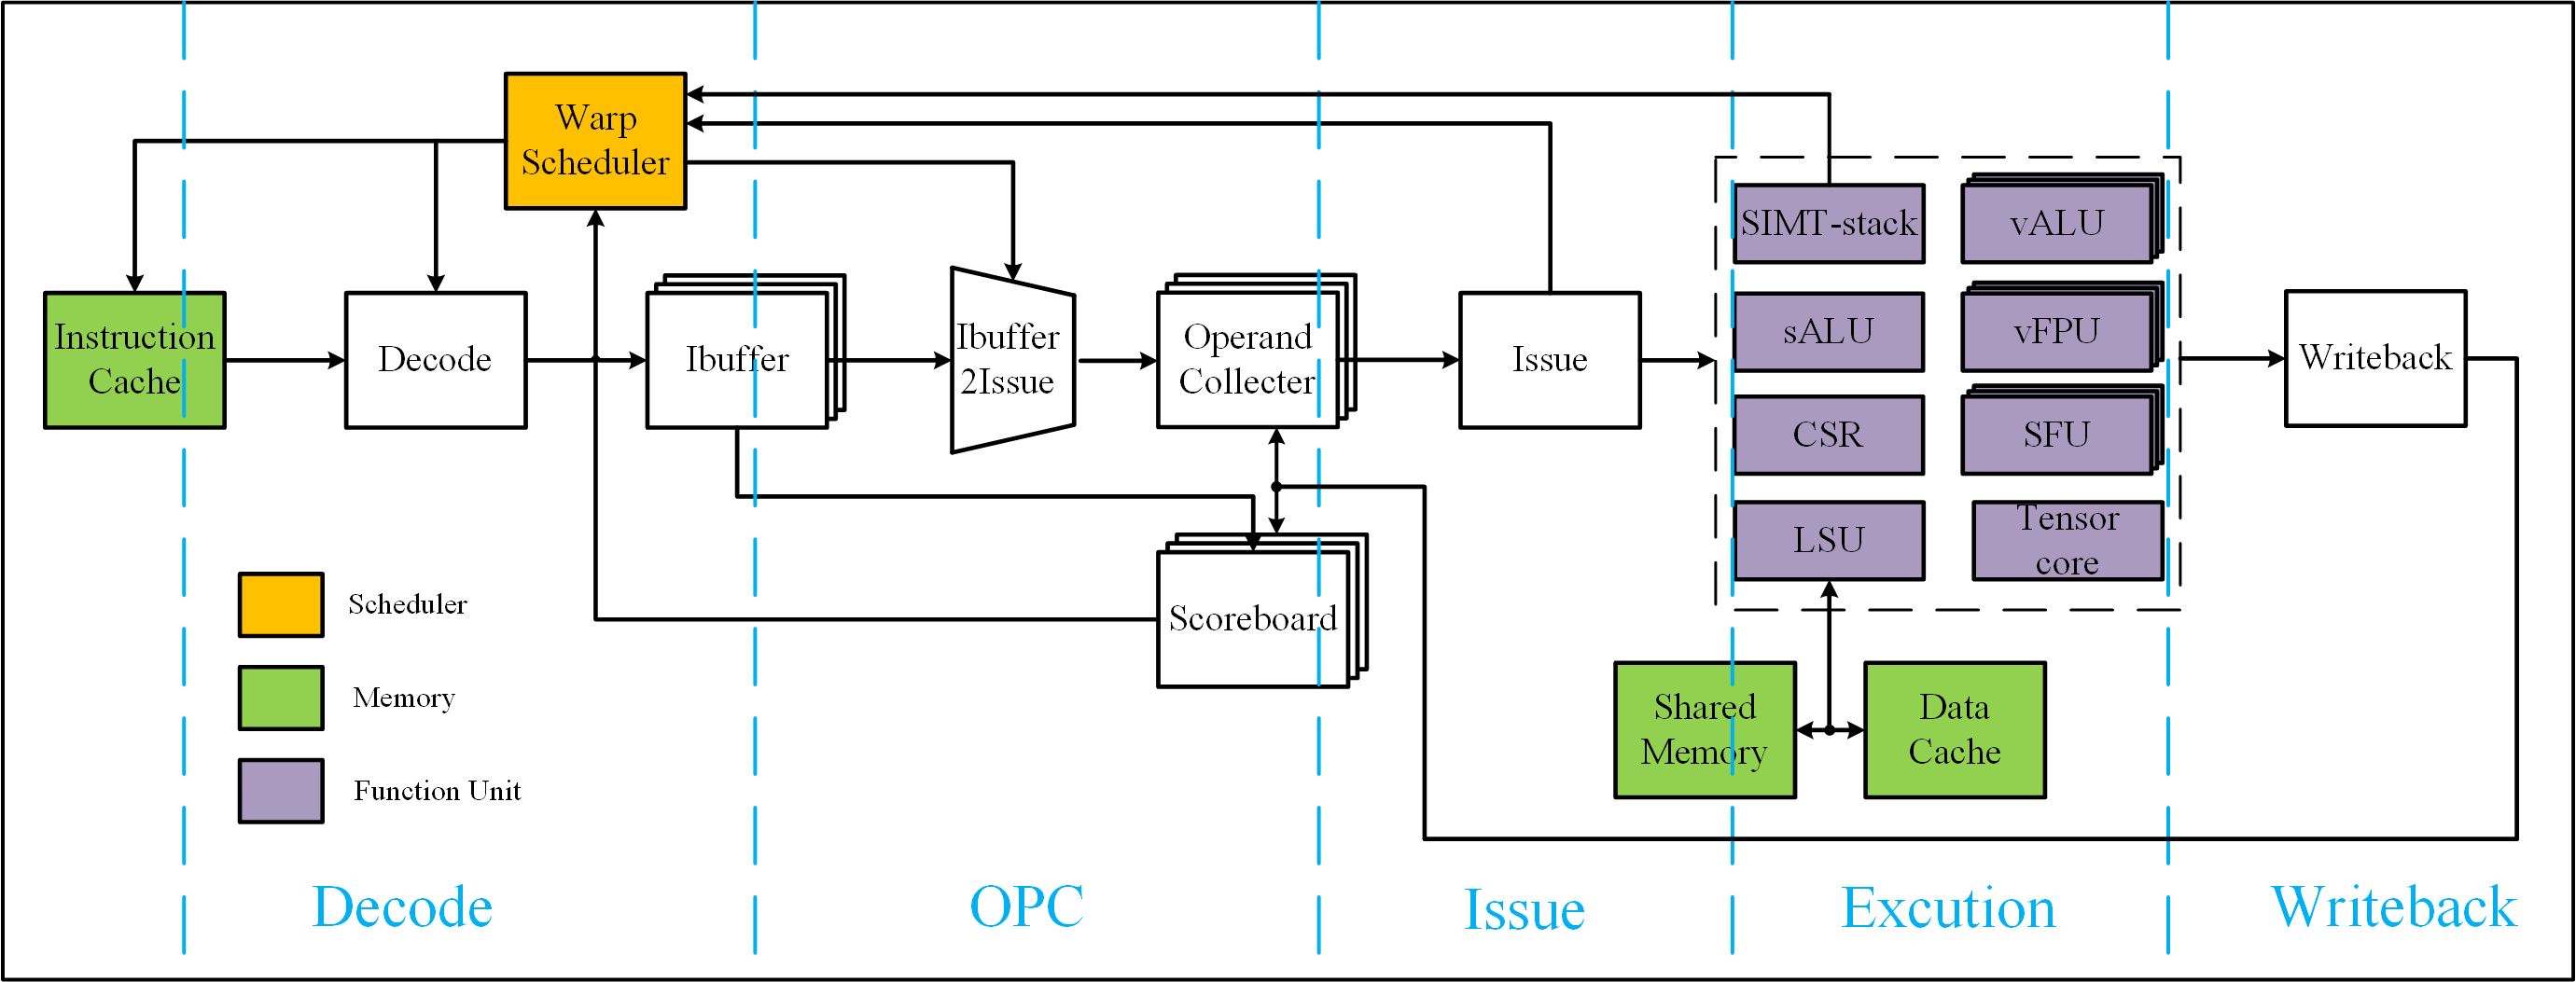 GPGPU的特点是SIMT,单指令多线程,在高度并行化同时保证了一定灵活的可编程性。得以通过大量的高性能编译器与算子库开发不断更新,对基本上所有可以通过并行进行加速的算法做支持,取得不错的加速效果。
CUDA&Triton编程学习网站 LeetGPU
前言
编写 CUDA kernel 的复杂性与 C++ 相当,还加入了许多 GPU 内存管理设置:内存合并、bank conflicts、线程块配置、共享内存管理……这些细节往往让人望而却步。Triton 的出现改变了这一切。它是 OpenAI 开发的一个开源 GPU 编程语言,让你可以用 Python 风格的语法编写高性能的 GPU kernel,而无需过多关心底层的硬件细节(实际上理解硬件架构仍然很重要)。
#include <cuda_runtime.h>

__global__ void vector_add(const float* A, const float* B, float* C, int N) {
    int idx = threadIdx.x + blockDim.x*blockIdx.x;

    if (idx < N) {
        C[idx] = B[idx] + A[idx];
    }
}

// A, B, C are device pointers (i.e. pointers to memory on the GPU)
extern "C" void solve(const float* A, const float* B, float* C, int N) {
    int threadsPerBlock = 256;
    int blocksPerGrid = (N + threadsPerBlock - 1) / threadsPerBlock;

    vector_add<<<blocksPerGrid, threadsPerBlock>>>(A, B, C, N);
    cudaDeviceSynchronize();
}
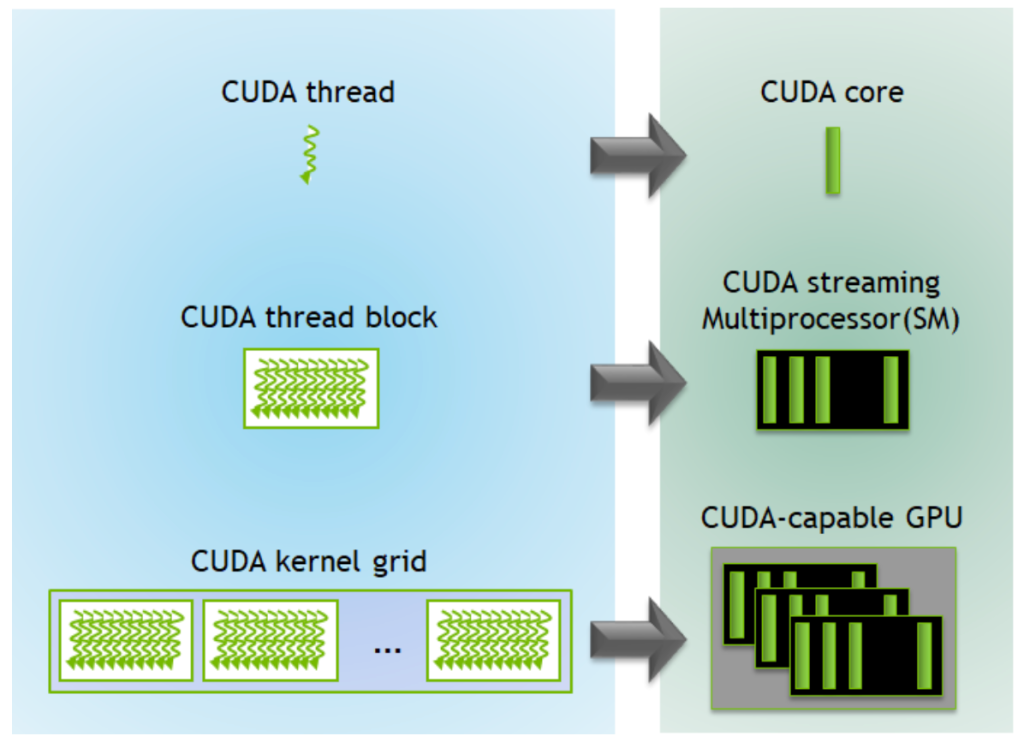
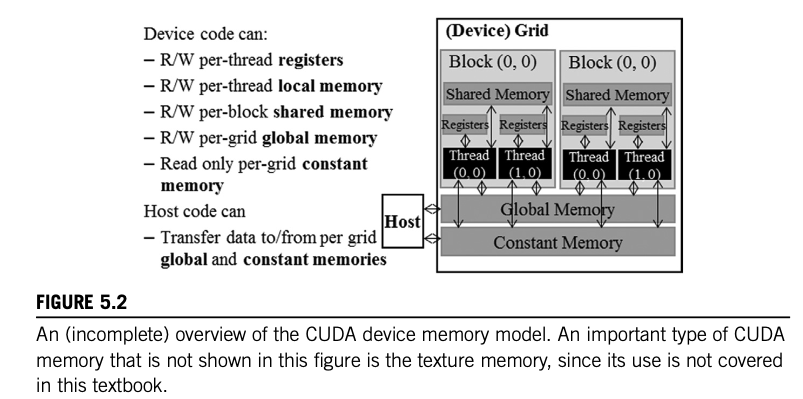 需要参展CUDA编程与GPU内存架构,手动实现所需线程、块...的管理,在进行优化时还要实现共享内存等更复杂的操作。
与之相比,OpenAI 研发的 Triton 是一个专门为深度学习和高性能计算任务设计的编程语言和编译器,它旨在简化并优化在GPU上执行的复杂操作的开发。核心特点是积极拥抱pytorch生态(pytorch为了支持高性能AI计算,提供了torch.compile装饰类,像c语言一样将函数类just in time编译为更高效的静态图,并且可以autotune优化),为程序员在实现稀疏操作时提供了更多的灵活性,同时允许编译器为数据局部性和并行性进行积极的优化。
import torch
import triton
import triton.language as tl

@triton.jit
def vector_add_kernel(a, b, c, n_elements, BLOCK_SIZE: tl.constexpr):
    pid = tl.program_id(0)
    offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
    mask = offsets < n_elements
    x = tl.load(a + offsets, mask=mask)
    y = tl.load(b + offsets, mask=mask)
    tl.store(c + offsets, x + y, mask=mask)

# a, b, c are tensors on the GPU
def solve(a: torch.Tensor, b: torch.Tensor, c: torch.Tensor, N: int):
    BLOCK_SIZE = 1024
    grid = (triton.cdiv(N, BLOCK_SIZE),)
    vector_add_kernel[grid](a, b, c, N, BLOCK_SIZE)
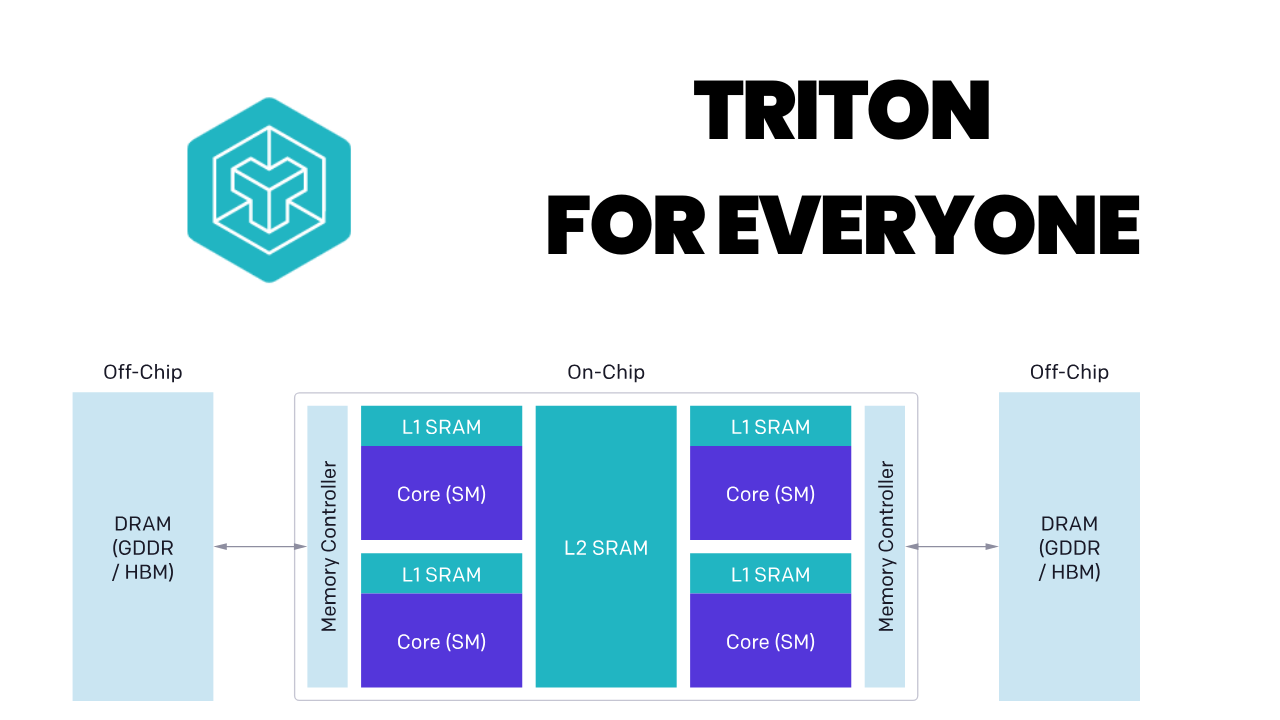
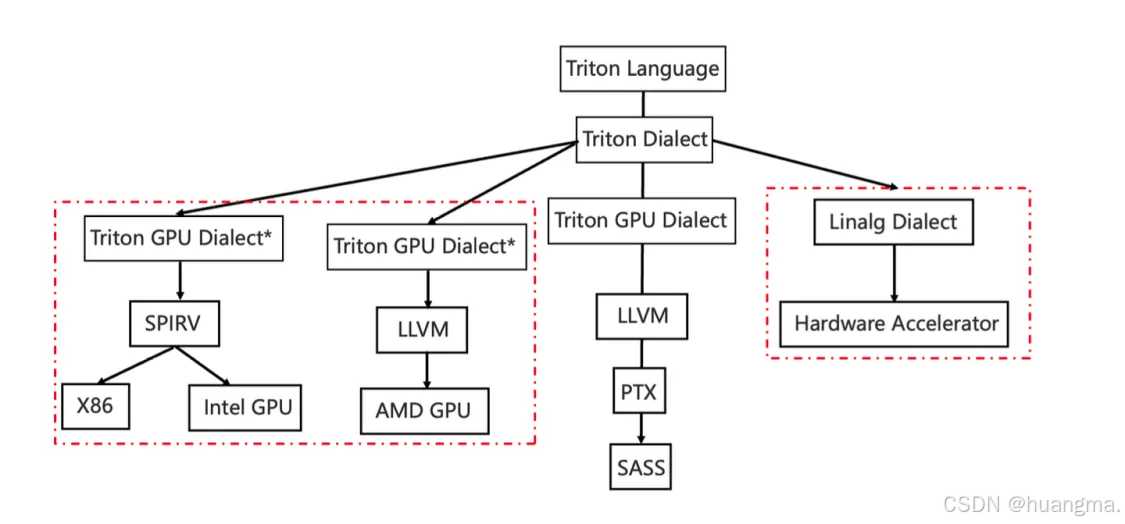
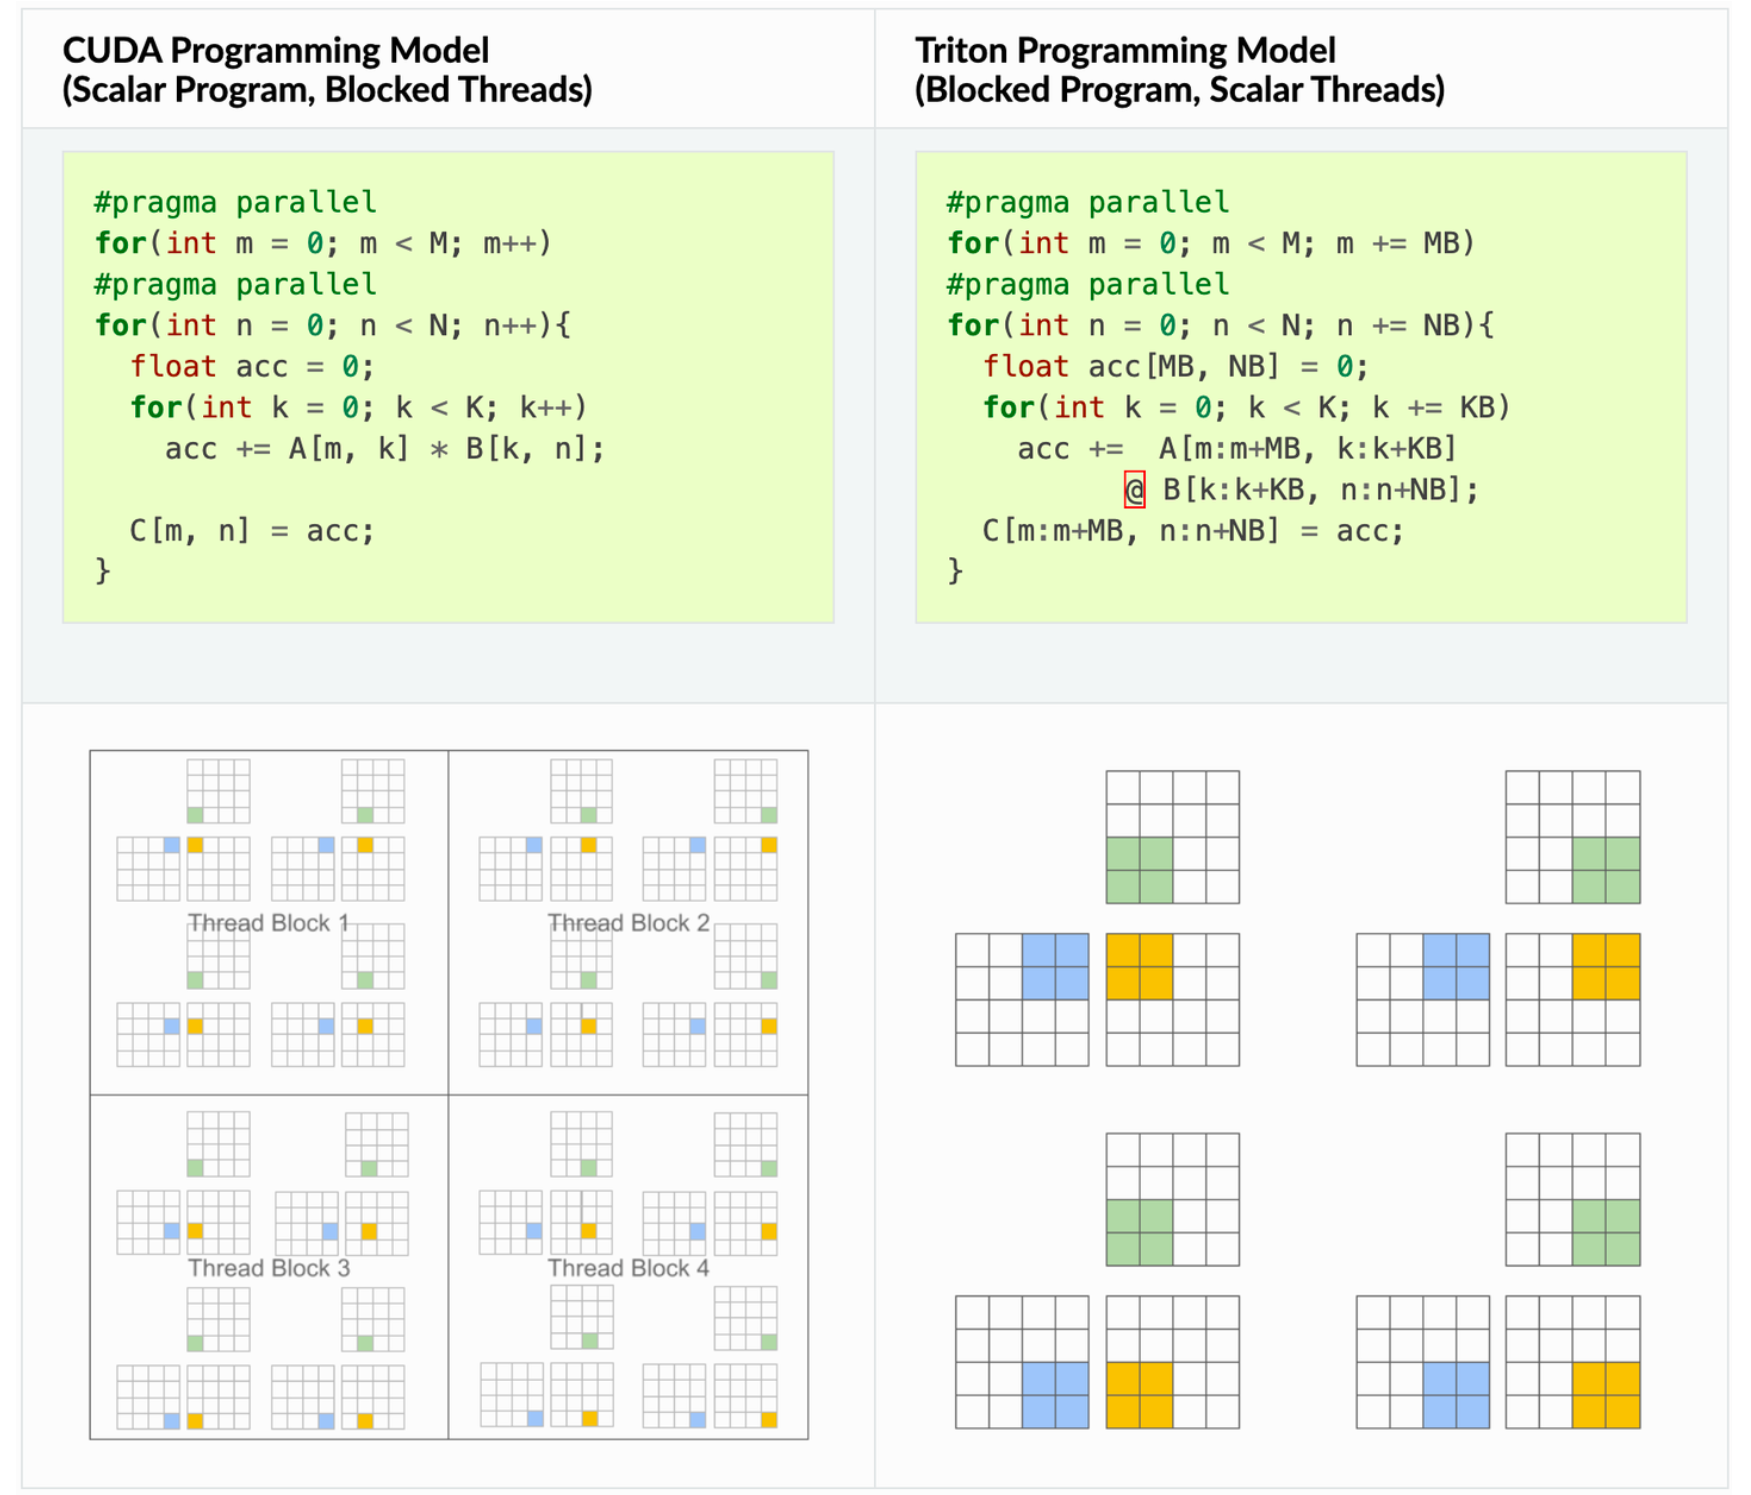
Triton 的核心理念是基于分块的编程范式可以促进神经网络的高性能计算核心的构建。CUDA 编写属于传统的 “单程序,多数据” GPU 执行模型,在线程的细粒度上进行编程,Triton 是在分块的细粒度上进行编程。
编译器框架
目前主流的编译器后端框架实现是llvm(Low Level Virtual Machine)(包括Nvidia在内各大厂商都在使用,作为cuda或其他前端编程语言的后端),实现编程语言到硬件执行代码(例如nvidia的PTX)的转换。
我来PTX分享链接 PTX

 MLIR(Multi-Level Intermediate Representation)通常将LLVM IR作为其最低层的一个Dialect。当一个MLIR程序经过一系列lowering后,最终会转换成LLVM::Dialect,然后被翻译成标准的LLVM IR,交给LLVM后端去生成机器码。这种特性以及开源生态使得各种国产厂商几乎都基于MLIR去构建自己的软件栈。
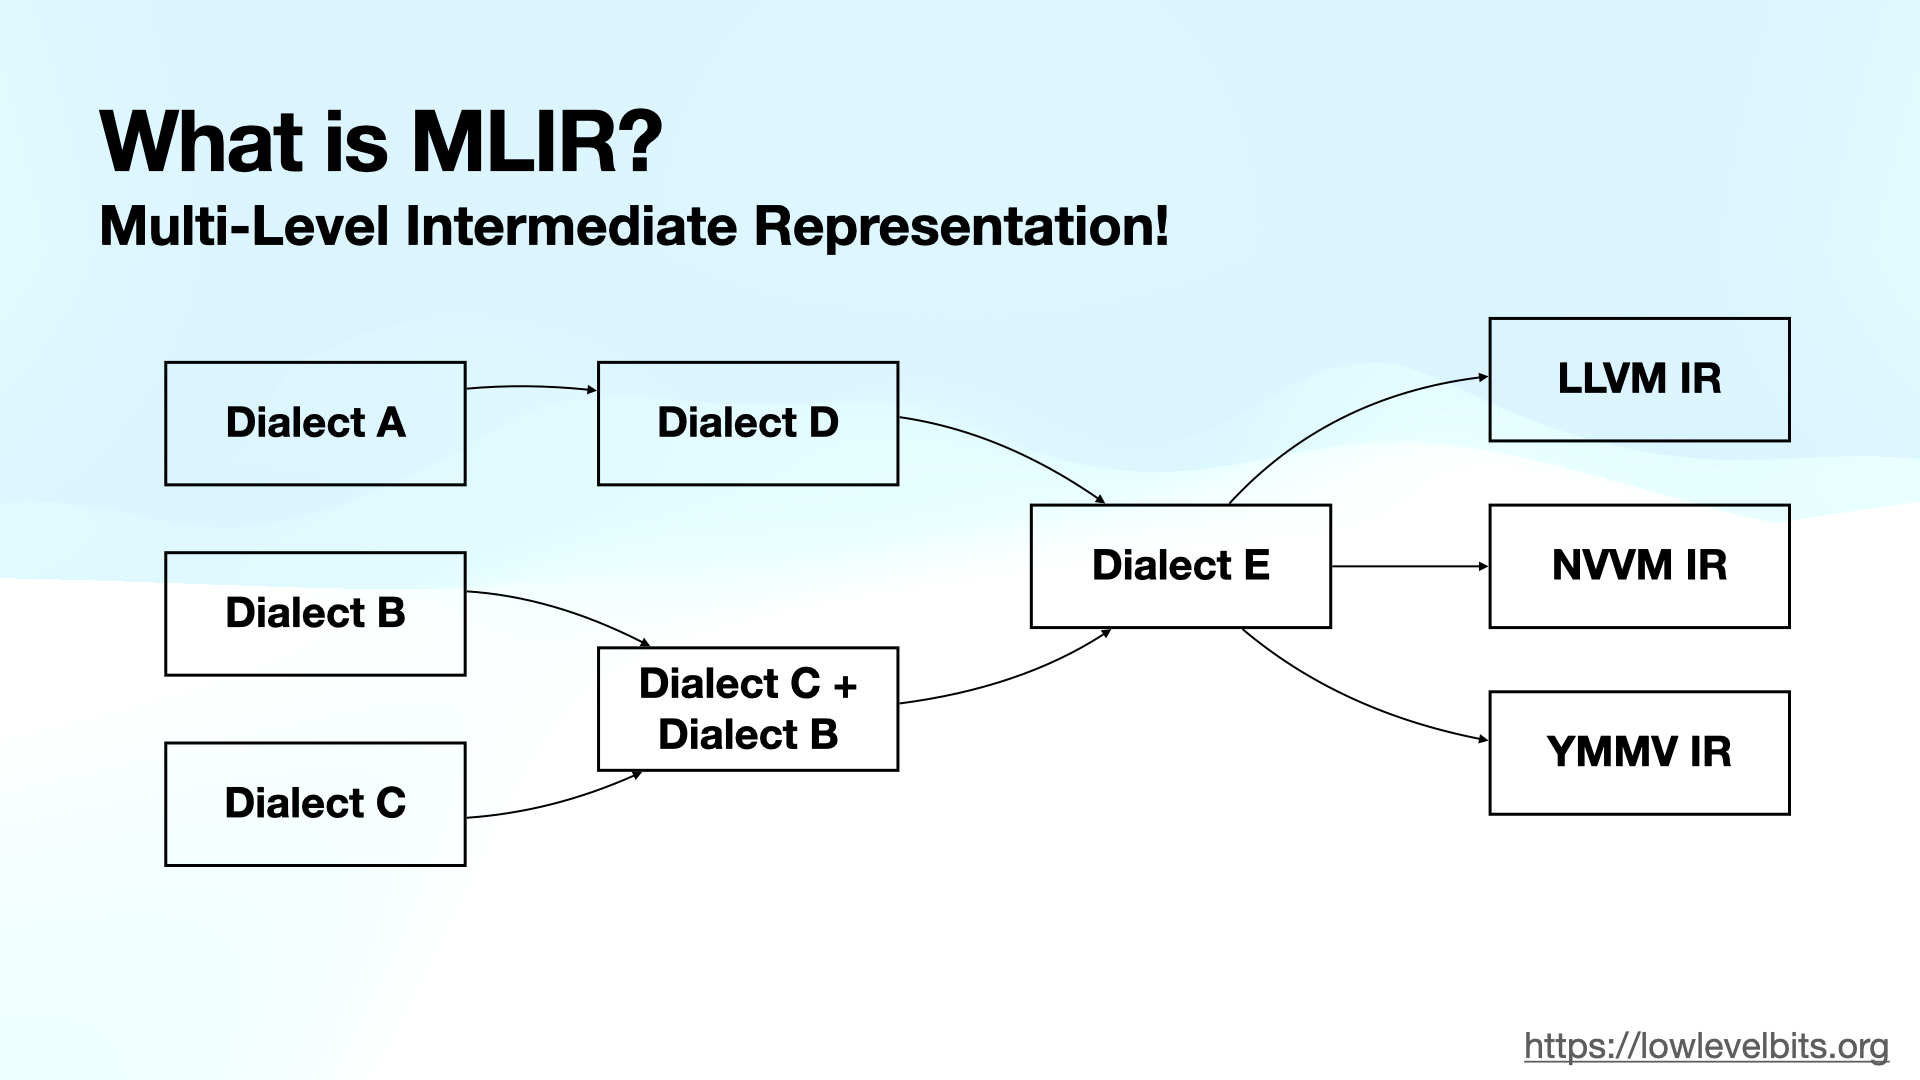
在成熟的平台(Nvidia GPU),因为生态完成支持完善,基本所需的所有操作都有高性能算子支持。用户无需考虑编译仅需按照需求,使用cuda/Triton对自己的算法做高效的实现。 而Triton的价值是,使得这个过程学习曲线更加平缓,上手更加简单。但是Triton与CUDA性能还是有差距(目前网上平均的数据能够达到CUDA的90%),对于学术研究来说便捷性胜过了性能损失。
实战场景
面向GPU平台,针对新的模型算法,实现GPU高效推理/训练。 e.g. Accelerating 3D Gaussian Splatting with Neural Sorting and Axis-Oriented Rasterization
针对特殊的加速算法,在GPU上实现加速效果。
e.g. SynGPU: Synergizing CUDA and Bit-Serial Tensor Cores for Vision Transformer Acceleration on GPU。 SynGPU
软硬件协同设计:Triton 的实战价值
在深入 Triton 的技术细节之前,让我们先看看它在实际应用中的威力。Triton 不仅是一个编程工具,更是连接算法创新与硬件性能的桥梁。在 AI 系统优化领域,软硬件协同设计已经成为获得性能突破的关键路径。
为什么软硬件协同设计如此重要?
现代 GPU 硬件(如 NVIDIA 的 Tensor Core、稀疏加速器)提供了强大的计算能力,但这些能力只有通过精心设计的算法才能充分发挥。传统方法中,算法研究者和系统优化者之间存在巨大鸿沟:
- 算法研究者:提出创新想法(如稀疏化、量化、新型 attention),但难以快速验证硬件性能
- 系统工程师:精通 CUDA 优化,但难以快速迭代新算法
Triton 打破了这一鸿沟,让研究者能够: 1. 快速实现新算法的高效 GPU 实现 2. 充分利用硬件特性(Tensor Core、稀疏加速等) 3. 在训练和推理场景中实现显著加速
经典案例 1:NVIDIA 2:4 结构化稀疏
背景:NVIDIA Ampere 架构引入了 2:4 结构化稀疏支持——在每连续 4 个元素中,至少 2 个为零时,可以获得 2x 理论加速。
硬件特性: - Tensor Core 原生支持 2:4 稀疏矩阵乘法 - 可在不损失精度的情况下加速推理和训练
Triton 实现:
@triton.jit
def sparse_matmul_kernel_2_4(
    # 稀疏矩阵 A (2:4 格式)
    a_values_ptr,  # 非零值
    a_metadata_ptr,  # 稀疏元数据
    b_ptr,  # 密集矩阵 B
    c_ptr,  # 输出矩阵 C
    M, N, K,
    BLOCK_M: tl.constexpr,
    BLOCK_N: tl.constexpr,
    BLOCK_K: tl.constexpr,
):
    """
    实现 2:4 结构化稀疏矩阵乘法
    利用 NVIDIA Sparse Tensor Core
    """
    # 获取 program ID
    pid = tl.program_id(0)
    num_pid_n = tl.cdiv(N, BLOCK_N)
    pid_m = pid // num_pid_n
    pid_n = pid % num_pid_n

    # 创建偏移量
    offs_am = pid_m * BLOCK_M + tl.arange(0, BLOCK_M)
    offs_bn = pid_n * BLOCK_N + tl.arange(0, BLOCK_N)
    offs_k = tl.arange(0, BLOCK_K)

    # 初始化累加器
    accumulator = tl.zeros((BLOCK_M, BLOCK_N), dtype=tl.float32)

    # 处理稀疏矩阵 A
    # 2:4 稀疏:每 4 个元素只存储 2 个非零值
    for k in range(0, K, BLOCK_K):
        # 加载稀疏矩阵的压缩表示
        # 实际中会使用 Sparse Tensor Core 指令
        a_compressed = tl.load(a_values_ptr + offs_am[:, None] * (K // 2) + offs_k[None, :] // 2)
        metadata = tl.load(a_metadata_ptr + offs_am[:, None] * (K // 4) + offs_k[None, :] // 4)

        # 加载密集矩阵 B
        b = tl.load(b_ptr + (k + offs_k[:, None]) * N + offs_bn[None, :])

        # 稀疏矩阵乘法(编译器会映射到 Sparse Tensor Core)
        accumulator += tl.dot(a_compressed, b, allow_tf32=False)

    # 存储结果
    c_ptrs = c_ptr + offs_am[:, None] * N + offs_bn[None, :]
    tl.store(c_ptrs, accumulator)
实际加速效果: - 推理:在 BERT 模型上获得 1.7x 端到端加速 - 训练:在保持精度的同时,训练速度提升 1.3-1.5x - 内存:模型大小减少约 50%
GitHub 资源: - NVIDIA ASP (Automatic SParsity) - Triton 稀疏实现示例
经典案例 2:量化感知训练 (QAT) 的 Triton 加速
背景:量化(INT8/INT4)是推理加速的关键技术,但量化感知训练需要在前向和反向传播中模拟量化效果。
挑战: - PyTorch 原生的 fake quantization 操作不够高效 - 需要融合多个操作:scale、round、clamp
Triton 解决方案:
@triton.jit
def fused_quantize_dequantize_kernel(
    x_ptr, scale_ptr, zero_point_ptr, output_ptr,
    n_elements,
    n_bits: tl.constexpr,
    BLOCK_SIZE: tl.constexpr,
):
    """
    融合的量化-反量化操作,用于 QAT

    操作序列:
    1. x_scaled = x / scale
    2. x_rounded = round(x_scaled + zero_point)
    3. x_clamped = clamp(x_rounded, qmin, qmax)
    4. x_dequant = (x_clamped - zero_point) * scale
    """
    pid = tl.program_id(0)
    block_start = pid * BLOCK_SIZE
    offsets = block_start + tl.arange(0, BLOCK_SIZE)
    mask = offsets < n_elements

    # 加载数据
    x = tl.load(x_ptr + offsets, mask=mask, other=0.0)
    scale = tl.load(scale_ptr + offsets, mask=mask, other=1.0)
    zero_point = tl.load(zero_point_ptr + offsets, mask=mask, other=0.0)

    # 量化范围
    qmin = 0.0
    qmax = (1 << n_bits) - 1  # 2^n_bits - 1

    # 融合的量化-反量化
    x_scaled = x / scale
    x_shifted = x_scaled + zero_point
    x_rounded = tl.libdevice.rint(x_shifted)  # 四舍五入
    x_clamped = tl.minimum(tl.maximum(x_rounded, qmin), qmax)
    x_dequant = (x_clamped - zero_point) * scale

    # 存储结果
    tl.store(output_ptr + offsets, x_dequant, mask=mask)

@triton.jit
def int8_matmul_kernel(
    a_ptr, b_ptr, c_ptr,
    a_scale_ptr, b_scale_ptr,
    M, N, K,
    BLOCK_M: tl.constexpr,
    BLOCK_N: tl.constexpr,
    BLOCK_K: tl.constexpr,
):
    """
    INT8 矩阵乘法,充分利用 Tensor Core 的 INT8 支持
    """
    pid = tl.program_id(0)
    num_pid_n = tl.cdiv(N, BLOCK_N)
    pid_m = pid // num_pid_n
    pid_n = pid % num_pid_n

    # ... (类似前面的 matmul,但使用 INT8 数据类型)

    # 关键:Triton 编译器会自动使用 INT8 Tensor Core
    accumulator = tl.dot(a_int8, b_int8, acc_dtype=tl.int32)

    # 反量化
    c_float = accumulator.to(tl.float32) * a_scale * b_scale

    tl.store(c_ptr + offsets, c_float)
性能提升: - 训练:QAT 操作加速 2-3x(相比 PyTorch fake_quantize) - 推理:INT8 推理在 Transformer 模型上达到 3-4x 加速 - 精度保持:可以保持与 FP16 相当的精度
实际项目: - bitsandbytes - 8-bit 优化器和量化 - GPTQ - 用 Triton 实现的 4-bit 量化 - AutoGPTQ - 生产级 GPTQ 实现
经典案例 3:Flash Attention - 训练加速的突破
背景:标准 Attention 的内存复杂度是 O(N²),限制了长序列训练。
创新点: - Tiling:将 Q、K、V 分块处理,避免实例化完整的 attention matrix - 重计算:反向传播时重新计算,换内存换时间 - IO 感知:最小化 HBM 访问次数
Triton 实现的优势:
# Flash Attention 的核心 - 在线 softmax
@triton.jit
def flash_attention_fwd_kernel(...):
    # 关键创新:增量更新 softmax 统计量
    m_i = tl.full([BLOCK_M], value=-float('inf'), dtype=tl.float32)  # 最大值
    l_i = tl.zeros([BLOCK_M], dtype=tl.float32)  # 归一化因子
    acc = tl.zeros([BLOCK_M, BLOCK_K], dtype=tl.float32)  # 累加器

    # 分块处理 K 和 V
    for start_n in range(0, N, BLOCK_N):
        # 计算当前块的 attention scores
        qk = tl.dot(q, k) * scale

        # 更新统计量(数值稳定的在线 softmax)
        m_ij = tl.max(qk, axis=1)
        m_i_new = tl.maximum(m_i, m_ij)
        alpha = tl.exp(m_i - m_i_new)
        p = tl.exp(qk - m_i_new[:, None])

        # 更新累加器
        l_i_new = alpha * l_i + tl.sum(p, axis=1)
        acc = alpha[:, None] * acc + tl.dot(p, v)

        m_i = m_i_new
        l_i = l_i_new

    # 最终归一化
    acc = acc / l_i[:, None]
实测性能(GPT-2 训练): - 序列长度 1024:加速 2.4x,内存减少 10x - 序列长度 2048:加速 3.2x,内存减少 16x - 序列长度 4096:加速 4.1x,内存减少 25x
使得可能的应用: - 在单个 A100 (40GB) 上训练序列长度 16K 的模型 - 长文本理解、长期依赖建模
GitHub 资源: - Flash Attention 官方实现 - 包含 Triton 和优化 CUDA 版本 - Flash Attention v2 - 进一步优化
经典案例 4:混合精度训练的自定义算子
背景:FP16 训练可以加速 2x,但需要仔细处理数值稳定性。
Triton 实现 Fused LayerNorm + 混合精度:
@triton.jit
def fused_layernorm_fp16_kernel(
    output_ptr, input_ptr, weight_ptr, bias_ptr,
    mean_ptr, rstd_ptr,  # 保存统计量用于反向传播
    input_row_stride, output_row_stride,
    n_cols, eps,
    BLOCK_SIZE: tl.constexpr,
):
    """
    融合 LayerNorm,支持 FP16 输入/输出,FP32 累加
    """
    row_idx = tl.program_id(0)
    row_start_ptr = input_ptr + row_idx * input_row_stride
    col_offsets = tl.arange(0, BLOCK_SIZE)
    input_ptrs = row_start_ptr + col_offsets
    mask = col_offsets < n_cols

    # 加载 FP16 数据
    row_fp16 = tl.load(input_ptrs, mask=mask, other=0.0)

    # 转换到 FP32 进行统计计算(关键:数值稳定性)
    row = row_fp16.to(tl.float32)

    # Welford 算法:数值稳定的均值和方差计算
    mean = tl.sum(row, axis=0) / n_cols
    centered = row - mean
    variance = tl.sum(centered * centered, axis=0) / n_cols
    rstd = 1.0 / tl.sqrt(variance + eps)

    # 归一化(FP32)
    normalized = centered * rstd

    # 加载 weight 和 bias(FP32)
    weight = tl.load(weight_ptr + col_offsets, mask=mask).to(tl.float32)
    bias = tl.load(bias_ptr + col_offsets, mask=mask).to(tl.float32)

    # Affine 变换
    output = normalized * weight + bias

    # 转换回 FP16 存储
    output_fp16 = output.to(tl.float16)

    # 存储输出
    output_row_start_ptr = output_ptr + row_idx * output_row_stride
    output_ptrs = output_row_start_ptr + col_offsets
    tl.store(output_ptrs, output_fp16, mask=mask)

    # 保存统计量(用于反向传播)
    if mean_ptr is not None:
        tl.store(mean_ptr + row_idx, mean)
        tl.store(rstd_ptr + row_idx, rstd)
性能和精度: - 相比 PyTorch LayerNorm:加速 1.5-2x - 数值稳定性:FP32 累加确保精度 - 内存高效:直接 FP16 输入/输出
经典案例 5:稀疏 Attention 的多种变体
背景:完全 attention 的 O(N²) 复杂度限制了长序列。稀疏 attention 通过只计算部分位置的 attention 来降低复杂度。
Triton 的优势:可以快速实现各种稀疏模式。
@triton.jit
def sparse_attention_kernel(
    q_ptr, k_ptr, v_ptr, out_ptr,
    mask_ptr,  # 稀疏 mask
    stride_qz, stride_qh, stride_qm, stride_qk,
    # ... 其他参数
    BLOCK_M: tl.constexpr,
    BLOCK_N: tl.constexpr,
):
    """
    通用稀疏 Attention kernel
    支持多种稀疏模式:
    - Local attention (窗口)
    - Strided attention (固定步长)
    - Block sparse (块稀疏)
    - Random sparse (随机稀疏)
    """
    batch_idx = tl.program_id(0)
    head_idx = tl.program_id(1)
    block_m = tl.program_id(2)

    # 加载 Q
    offs_m = block_m * BLOCK_M + tl.arange(0, BLOCK_M)
    q = tl.load(q_ptr + ...)

    accumulator = tl.zeros([BLOCK_M, HEAD_DIM], dtype=tl.float32)

    # 只处理 mask 指定的块
    for block_n in range(0, N_BLOCKS):
        # 检查稀疏 mask
        mask_val = tl.load(mask_ptr + block_m * N_BLOCKS + block_n)

        if mask_val > 0:  # 只计算非零块
            # 加载 K、V
            k = tl.load(k_ptr + ...)
            v = tl.load(v_ptr + ...)

            # 计算 attention
            scores = tl.dot(q, k.T) * scale
            probs = tl.softmax(scores, axis=-1)
            accumulator += tl.dot(probs, v)

    # 存储结果
    tl.store(out_ptr + ..., accumulator)
不同稀疏模式的加速效果:
| 稀疏模式 | 稀疏度 | 序列长度 | 加速比 | 精度损失 |
|---|---|---|---|---|
| Local Window | 95% | 4096 | 8.2x | < 0.5% |
| Strided | 90% | 4096 | 6.1x | < 1% |
| Block Sparse | 87.5% | 4096 | 5.3x | < 0.3% |
| Random | 80% | 4096 | 3.8x | < 2% |
实际项目: - Longformer - 长文档 Transformer - BigBird - 稀疏 attention 多种模式 - Triton-based Sparse Attention
软硬件协同的更多应用领域
1. 训练加速
- 梯度累积优化:融合多个 mini-batch 的梯度更新
- 混合精度优化器:如 FP16 Adam、8-bit Adam
- 通信-计算重叠:在分布式训练中
示例项目: - DeepSpeed - 使用 Triton 优化训练 - Apex - NVIDIA 的混合精度库
2. 推理优化
- KV Cache 优化:高效管理 Transformer 推理的缓存
- Batching:动态批处理,提高吞吐量
- 算子融合:减少 kernel 启动开销
示例项目: - vLLM - PagedAttention,使用 Triton - TensorRT-LLM - 生产级推理 - Text Generation Inference - Hugging Face 推理引擎
3. 模型压缩
- 剪枝:结构化和非结构化剪枝的高效实现
- 知识蒸馏:自定义 loss 函数的高效计算
- 低秩分解:动态 rank 调整
示例项目: - Neural Compressor - Model Compression Toolkit
4. 新型架构优化
- State Space Models:如 Mamba、S4
- MoE (Mixture of Experts):动态路由和负载均衡
- Retrieval-Augmented Models:检索和生成的融合
示例项目: - Mamba - 使用 Triton 实现 - Megablocks - 高效 MoE
学习软硬件协同设计的路径
第一步:理解硬件特性 - GPU 架构基础(SM、Warp、Tensor Core) - 内存层次(Global、Shared、Register) - 计算与带宽的平衡
第二步:掌握 Triton 编程 - 基本算子实现(本文后续章节) - 性能分析和调优 - 编译器工作原理
第三步:实践软硬件协同 - 从简单的融合算子开始 - 逐步实现复杂的稀疏/量化算法 - 在真实模型中测试性能
第四步:贡献开源社区 - 为主流框架贡献优化 - 实现论文中的新算法 - 分享经验和最佳实践
总结:Triton 的战略价值
Triton 不仅仅是一个编程工具,它是算法创新通往生产部署的快速通道:
- 研究加速:从想法到验证,从数周缩短到数天
- 性能提升:在实际模型中获得 2-10x 的加速
- 成本降低:更高效的硬件利用,降低训练和推理成本
- 竞争优势:快速实现最新算法,保持技术领先
接下来,让我们深入了解 Triton 的技术细节,掌握这个强大的工具。
一、Triton 是什么?
1.1 核心理念
Triton 是一个用于编写高效 GPU kernel 的编程语言和编译器。它的设计哲学可以概括为:
"让程序员专注于算法逻辑,让编译器处理硬件优化"
与传统的 CUDA 编程相比,Triton 具有以下特点:
- 更高的抽象层次:以 tile(数据块)为基本单位,而非单个线程
- 自动内存优化:编译器自动处理内存合并、共享内存分配等
- Python 原生集成:与 PyTorch 等深度学习框架无缝集成
- 性能不妥协:在许多场景下可以达到甚至超越手写 CUDA 的性能
1.2 为什么需要 Triton?
让我们通过一个简单的例子来说明。假设我们要实现一个向量加法:
CUDA 版本需要考虑的问题:
// 需要手动管理线程索引
int idx = blockIdx.x * blockDim.x + threadIdx.x;
// 需要考虑边界条件
if (idx < n) {
    c[idx] = a[idx] + b[idx];
}
// 还要考虑:线程块大小、grid 配置、内存访问模式...
Triton 版本:
# 直接以数据块(tile)为单位思考
pid = tl.program_id(0)
block_start = pid * BLOCK_SIZE
offsets = block_start + tl.arange(0, BLOCK_SIZE)
a = tl.load(a_ptr + offsets, mask=offsets < n)
b = tl.load(b_ptr + offsets, mask=offsets < n)
c = a + b
tl.store(c_ptr + offsets, c, mask=offsets < n)
可以看到,Triton 的代码更接近我们的思维方式,而且编译器会自动优化内存访问模式。
1.3 Triton 的应用场景
Triton 特别适合以下场景:
- 深度学习算子开发:自定义 layer、fusion 操作
- 矩阵运算:GEMM、卷积等
- 元素级运算:activation、normalization
- Attention 机制:Flash Attention 就是用 Triton 实现的
- 稀疏计算:稀疏矩阵乘法等
二、Triton 的编译架构
2.1 编译流程概览
Triton 的编译流程可以分为以下几个阶段:
Python DSL (用户代码)
    ↓
Triton IR (中间表示)
    ↓
Triton GPU IR (GPU 特化的 IR)
    ↓
LLVM IR
    ↓
PTX (NVIDIA) / AMDGCN (AMD)
    ↓
GPU Binary
这个多层 IR 的设计让 Triton 可以在不同层次进行优化,同时保持跨平台的兼容性。
2.2 核心编译组件
2.2.1 前端:Python DSL
Triton 使用 Python 作为前端语言,但并不是直接执行 Python 代码,而是将其编译为 GPU kernel。这个过程通过装饰器 @triton.jit 实现:
关键点:
- 使用 tl.constexpr 标记编译时常量
- 支持 Python 的控制流(if、for 等)
- 不支持所有 Python 特性(如动态类型、异常处理等)
2.2.2 中间表示:Triton IR
Triton IR 是一种基于 MLIR(Multi-Level Intermediate Representation)的中间表示。MLIR 是 LLVM 项目的一部分,提供了灵活的 IR 框架。
一个简单的 Triton IR 示例:
func @add_kernel(%arg0: !tt.ptr<f32>, %arg1: !tt.ptr<f32>,
                 %arg2: !tt.ptr<f32>, %arg3: i32) {
  %0 = tt.get_program_id {axis = 0 : i32} : i32
  %1 = arith.muli %0, %block_size : i32
  %2 = tt.make_range {end = 1024 : i32, start = 0 : i32} : tensor<1024xi32>
  %3 = tt.splat %1 : (i32) -> tensor<1024xi32>
  %4 = arith.addi %3, %2 : tensor<1024xi32>
  // ...
}
2.2.3 后端优化
Triton 编译器在后端进行多种优化:
- 自动向量化:将标量操作转换为向量操作
- 内存合并:优化全局内存访问模式
- 共享内存分配:自动管理共享内存的使用
- 指令调度:优化指令执行顺序以隐藏延迟
- 寄存器分配:高效利用寄存器资源
2.3 与 CUDA 编译流程对比
| 特性 | CUDA | Triton |
|---|---|---|
| 编程抽象 | 线程级 | 块级(tile) |
| 内存管理 | 手动 | 自动 |
| 优化责任 | 程序员 | 编译器 |
| 编译器 | nvcc | triton compiler |
| IR | NVVM IR → PTX | Triton IR → LLVM IR → PTX |
| 可移植性 | NVIDIA only | NVIDIA + AMD |
| 学习曲线 | 陡峭 | 平缓 |
三、Triton vs CUDA:深度对比
3.1 编程模型对比
3.1.1 线程模型
CUDA: - 基于 SIMT (Single Instruction, Multiple Threads) - 程序员需要显式管理线程层次:thread → block → grid - 一个 kernel 函数对应一个线程的执行
__global__ void vector_add(float *a, float *b, float *c, int n) {
    int tid = blockIdx.x * blockDim.x + threadIdx.x;
    if (tid < n) {
        c[tid] = a[tid] + b[tid];
    }
}
Triton: - 基于 SPMD (Single Program, Multiple Data) - 以 program instance 为单位,每个 instance 处理一个数据块 - 程序员只需要关心一个数据块的处理逻辑
@triton.jit
def vector_add_kernel(a_ptr, b_ptr, c_ptr, n, BLOCK_SIZE: tl.constexpr):
    pid = tl.program_id(0)
    block_start = pid * BLOCK_SIZE
    offsets = block_start + tl.arange(0, BLOCK_SIZE)
    mask = offsets < n
    a = tl.load(a_ptr + offsets, mask=mask)
    b = tl.load(b_ptr + offsets, mask=mask)
    c = a + b
    tl.store(c_ptr + offsets, c, mask=mask)
3.1.2 内存层次
CUDA 的内存模型:
__global__ void matmul_cuda(float *A, float *B, float *C, int M, int N, int K) {
    __shared__ float As[BLOCK_SIZE][BLOCK_SIZE];  // 手动声明共享内存
    __shared__ float Bs[BLOCK_SIZE][BLOCK_SIZE];

    int tx = threadIdx.x, ty = threadIdx.y;
    int bx = blockIdx.x, by = blockIdx.y;

    float sum = 0.0f;
    for (int tile = 0; tile < (K + BLOCK_SIZE - 1) / BLOCK_SIZE; tile++) {
        // 手动加载数据到共享内存
        if (by * BLOCK_SIZE + ty < M && tile * BLOCK_SIZE + tx < K)
            As[ty][tx] = A[(by * BLOCK_SIZE + ty) * K + tile * BLOCK_SIZE + tx];
        else
            As[ty][tx] = 0.0f;

        if (tile * BLOCK_SIZE + ty < K && bx * BLOCK_SIZE + tx < N)
            Bs[ty][tx] = B[(tile * BLOCK_SIZE + ty) * N + bx * BLOCK_SIZE + tx];
        else
            Bs[ty][tx] = 0.0f;

        __syncthreads();  // 手动同步

        for (int k = 0; k < BLOCK_SIZE; k++)
            sum += As[ty][k] * Bs[k][tx];

        __syncthreads();
    }

    if (by * BLOCK_SIZE + ty < M && bx * BLOCK_SIZE + tx < N)
        C[(by * BLOCK_SIZE + ty) * N + bx * BLOCK_SIZE + tx] = sum;
}
Triton 的内存处理:
@triton.jit
def matmul_kernel(a_ptr, b_ptr, c_ptr, M, N, K,
                  stride_am, stride_ak, stride_bk, stride_bn, stride_cm, stride_cn,
                  BLOCK_M: tl.constexpr, BLOCK_N: tl.constexpr, BLOCK_K: tl.constexpr):
    pid = tl.program_id(0)
    num_pid_n = tl.cdiv(N, BLOCK_N)
    pid_m = pid // num_pid_n
    pid_n = pid % num_pid_n

    offs_am = pid_m * BLOCK_M + tl.arange(0, BLOCK_M)
    offs_bn = pid_n * BLOCK_N + tl.arange(0, BLOCK_N)
    offs_k = tl.arange(0, BLOCK_K)

    a_ptrs = a_ptr + (offs_am[:, None] * stride_am + offs_k[None, :] * stride_ak)
    b_ptrs = b_ptr + (offs_k[:, None] * stride_bk + offs_bn[None, :] * stride_bn)

    accumulator = tl.zeros((BLOCK_M, BLOCK_N), dtype=tl.float32)

    for k in range(0, K, BLOCK_K):
        a = tl.load(a_ptrs)  # 编译器自动处理共享内存
        b = tl.load(b_ptrs)
        accumulator += tl.dot(a, b)  # 高效的矩阵乘法
        a_ptrs += BLOCK_K * stride_ak
        b_ptrs += BLOCK_K * stride_bk

    c_ptrs = c_ptr + (offs_am[:, None] * stride_cm + offs_bn[None, :] * stride_cn)
    tl.store(c_ptrs, accumulator)
注意 Triton 版本中:
- 没有显式的 __shared__ 声明
- 没有手动的 __syncthreads()
- 编译器自动决定何时使用共享内存
3.2 性能对比
让我们通过实际测试来比较性能。以向量加法为例:
测试环境
- GPU: NVIDIA A100 40GB
- CUDA: 11.8
- Triton: 2.1.0
性能数据
| 向量大小 | PyTorch (ms) | CUDA (ms) | Triton (ms) |
|---|---|---|---|
| 1M | 0.023 | 0.018 | 0.019 |
| 10M | 0.189 | 0.145 | 0.148 |
| 100M | 1.834 | 1.421 | 1.435 |
可以看到,Triton 的性能非常接近手写 CUDA,在某些情况下甚至更好(因为编译器的优化可能比手写代码更优)。
3.3 开发效率对比
一个真实的例子:Flash Attention
CUDA 实现: - 代码行数:~1500 行 - 开发时间:数周 - 需要的知识:CUDA 编程、GPU 架构、内存优化、warp 级编程
Triton 实现: - 代码行数:~200 行 - 开发时间:数天 - 需要的知识:基本的 Python、Triton API
代码行数减少了约 87%,开发时间缩短了约 80%。
3.4 何时使用 CUDA,何时使用 Triton?
推荐使用 CUDA 的场景: 1. 需要极致性能优化的核心算子(如 cuBLAS、cuDNN) 2. 需要 warp 级原语(如 warp shuffle) 3. 需要使用 Tensor Core 的特定指令 4. 需要精细控制内存访问模式
推荐使用 Triton 的场景: 1. 快速原型开发 2. 自定义深度学习算子 3. 研究新算法 4. 大部分常规计算场景 5. 需要跨平台支持(NVIDIA + AMD)
四、Triton 语法详解
4.1 基本语法结构
4.1.1 Kernel 定义
import triton
import triton.language as tl

@triton.jit
def my_kernel(
    # 指针参数
    input_ptr,
    output_ptr,
    # 标量参数
    n_elements,
    # 编译时常量(使用 tl.constexpr)
    BLOCK_SIZE: tl.constexpr
):
    # Kernel 代码
    pass
关键点:
- @triton.jit:将函数标记为 Triton kernel
- tl.constexpr:标记编译时常量,用于 block size 等参数
4.1.2 Program ID
每个 program instance 都有一个唯一的 ID:
# 获取当前 program 在不同维度上的 ID
pid_x = tl.program_id(axis=0)  # x 维度
pid_y = tl.program_id(axis=1)  # y 维度
pid_z = tl.program_id(axis=2)  # z 维度

# 示例:2D grid 中的索引计算
pid = tl.program_id(0)
grid_n = tl.cdiv(N, BLOCK_N)  # cdiv: ceiling division
pid_m = pid // grid_n
pid_n = pid % grid_n
4.2 数据类型
Triton 支持以下数据类型:
# 整数类型
tl.int1    # 1-bit 整数(布尔值)
tl.int8    # 8-bit 整数
tl.int16   # 16-bit 整数
tl.int32   # 32-bit 整数
tl.int64   # 64-bit 整数

# 浮点类型
tl.float16  # 半精度
tl.bfloat16 # Brain Float 16
tl.float32  # 单精度
tl.float64  # 双精度

# 类型转换
x_int = x_float.to(tl.int32)
x_float = x_int.to(tl.float32)
4.3 内存操作
4.3.1 加载数据
# 基本加载
data = tl.load(ptr)

# 带 mask 的加载(处理边界)
mask = offsets < n_elements
data = tl.load(ptr + offsets, mask=mask, other=0.0)
# other: mask 为 False 时的默认值

# 批量加载(带 stride)
# 假设要加载一个矩阵的某一行
row_start = row_idx * stride
offsets = row_start + tl.arange(0, BLOCK_SIZE)
row_data = tl.load(matrix_ptr + offsets)
4.3.2 存储数据
# 基本存储
tl.store(ptr, data)

# 带 mask 的存储
mask = offsets < n_elements
tl.store(ptr + offsets, data, mask=mask)

# 注意:不要忘记 mask,否则可能越界写入
4.3.3 原子操作
# 原子加
tl.atomic_add(ptr, value, mask=mask)

# 原子最大值
tl.atomic_max(ptr, value, mask=mask)

# 原子最小值
tl.atomic_min(ptr, value, mask=mask)

# 原子交换
tl.atomic_xchg(ptr, value, mask=mask)

# 原子比较交换
tl.atomic_cas(ptr, cmp, val, mask=mask)
4.4 张量操作
4.4.1 创建张量
# 创建范围
offsets = tl.arange(0, BLOCK_SIZE)  # [0, 1, 2, ..., BLOCK_SIZE-1]

# 创建全零/全一张量
zeros = tl.zeros((BLOCK_M, BLOCK_N), dtype=tl.float32)
ones = tl.full((BLOCK_M, BLOCK_N), value=1.0, dtype=tl.float32)

# 广播(splat)
value = 42
tensor = tl.splat(value)  # 将标量广播为张量
4.4.2 数学运算
# 基本算术
c = a + b
c = a - b
c = a * b
c = a / b
c = a % b
c = a ** b  # 幂运算

# 数学函数
y = tl.exp(x)
y = tl.log(x)
y = tl.sqrt(x)
y = tl.sin(x)
y = tl.cos(x)
y = tl.abs(x)

# 矩阵乘法
c = tl.dot(a, b)  # 高效的矩阵乘法,可能使用 Tensor Core
4.4.3 归约操作
# 求和
total = tl.sum(tensor, axis=0)  # 沿某个轴求和

# 最大值/最小值
max_val = tl.max(tensor, axis=0)
min_val = tl.min(tensor, axis=0)

# 示例:Softmax 中的归约
row_max = tl.max(logits, axis=1, keep_dims=True)
numerator = tl.exp(logits - row_max)
denominator = tl.sum(numerator, axis=1, keep_dims=True)
softmax = numerator / denominator
4.5 控制流
# if-else
@triton.jit
def conditional_kernel(x_ptr, y_ptr, flag, BLOCK_SIZE: tl.constexpr):
    pid = tl.program_id(0)
    offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
    x = tl.load(x_ptr + offsets)

    if flag:
        y = x * 2
    else:
        y = x + 1

    tl.store(y_ptr + offsets, y)

# for 循环
@triton.jit
def loop_kernel(x_ptr, y_ptr, n_iterations, BLOCK_SIZE: tl.constexpr):
    pid = tl.program_id(0)
    offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
    x = tl.load(x_ptr + offsets)

    result = x
    for i in range(n_iterations):
        result = result * 2 + 1

    tl.store(y_ptr + offsets, result)

# while 循环(较少使用)
@triton.jit
def while_kernel(x_ptr, y_ptr, threshold, BLOCK_SIZE: tl.constexpr):
    pid = tl.program_id(0)
    offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
    x = tl.load(x_ptr + offsets)

    result = x
    i = 0
    while i < 10 and tl.sum(result) > threshold:
        result = result * 0.9
        i += 1

    tl.store(y_ptr + offsets, result)
4.6 高级特性
4.6.1 多维索引
@triton.jit
def matrix_kernel(matrix_ptr, output_ptr, M, N, BLOCK_M: tl.constexpr, BLOCK_N: tl.constexpr):
    pid_m = tl.program_id(0)
    pid_n = tl.program_id(1)

    # 创建 2D 偏移
    offs_m = pid_m * BLOCK_M + tl.arange(0, BLOCK_M)
    offs_n = pid_n * BLOCK_N + tl.arange(0, BLOCK_N)

    # 2D 索引:使用广播
    # offs_m[:, None] 创建列向量
    # offs_n[None, :] 创建行向量
    ptrs = matrix_ptr + offs_m[:, None] * N + offs_n[None, :]

    # 加载 2D 块
    block = tl.load(ptrs)

    # 处理...
    result = block * 2

    # 存储
    tl.store(ptrs, result)
4.6.2 步长(Stride)处理
@triton.jit
def strided_kernel(input_ptr, output_ptr,
                   M, N,
                   stride_im, stride_in,  # 输入步长
                   stride_om, stride_on,  # 输出步长
                   BLOCK_M: tl.constexpr, BLOCK_N: tl.constexpr):
    pid_m = tl.program_id(0)
    pid_n = tl.program_id(1)

    offs_m = pid_m * BLOCK_M + tl.arange(0, BLOCK_M)
    offs_n = pid_n * BLOCK_N + tl.arange(0, BLOCK_N)

    # 使用步长计算指针
    input_ptrs = (input_ptr +
                  offs_m[:, None] * stride_im +
                  offs_n[None, :] * stride_in)

    output_ptrs = (output_ptr +
                   offs_m[:, None] * stride_om +
                   offs_n[None, :] * stride_on)

    data = tl.load(input_ptrs)
    tl.store(output_ptrs, data * 2)
五、实战案例
现在让我们通过一系列从简单到复杂的实际案例来深入学习 Triton。
5.1 案例 1:向量加法(入门)
这是最简单的例子,但展示了 Triton 的核心概念。
import torch
import triton
import triton.language as tl

@triton.jit
def vector_add_kernel(
    x_ptr,  # 输入向量 x 的指针
    y_ptr,  # 输入向量 y 的指针
    output_ptr,  # 输出向量的指针
    n_elements,  # 向量长度
    BLOCK_SIZE: tl.constexpr,  # 每个 block 处理的元素数
):
    # 获取当前 program 的 ID
    pid = tl.program_id(axis=0)

    # 计算当前 block 处理的起始位置
    block_start = pid * BLOCK_SIZE

    # 生成当前 block 的所有偏移
    offsets = block_start + tl.arange(0, BLOCK_SIZE)

    # 创建 mask 处理边界情况
    mask = offsets < n_elements

    # 加载数据(带 mask)
    x = tl.load(x_ptr + offsets, mask=mask, other=0.0)
    y = tl.load(y_ptr + offsets, mask=mask, other=0.0)

    # 计算
    output = x + y

    # 存储结果
    tl.store(output_ptr + offsets, output, mask=mask)

def vector_add(x: torch.Tensor, y: torch.Tensor) -> torch.Tensor:
    # 输出张量
    output = torch.empty_like(x)

    # 检查输入
    assert x.is_cuda and y.is_cuda and output.is_cuda
    assert x.shape == y.shape

    n_elements = output.numel()

    # 选择 block size(经验值)
    BLOCK_SIZE = 1024

    # 计算需要的 grid size
    grid = lambda meta: (triton.cdiv(n_elements, meta['BLOCK_SIZE']),)

    # 启动 kernel
    vector_add_kernel[grid](x, y, output, n_elements, BLOCK_SIZE)

    return output

# 测试
if __name__ == '__main__':
    size = 98432
    x = torch.rand(size, device='cuda')
    y = torch.rand(size, device='cuda')

    # Triton 版本
    output_triton = vector_add(x, y)

    # PyTorch 版本
    output_torch = x + y

    # 验证正确性
    print(f'最大误差: {torch.max(torch.abs(output_triton - output_torch))}')

    # 性能测试
    import time

    # 预热
    for _ in range(10):
        vector_add(x, y)

    torch.cuda.synchronize()
    start = time.time()
    for _ in range(100):
        vector_add(x, y)
    torch.cuda.synchronize()
    end = time.time()

    triton_time = (end - start) / 100

    # PyTorch 性能
    torch.cuda.synchronize()
    start = time.time()
    for _ in range(100):
        _ = x + y
    torch.cuda.synchronize()
    end = time.time()

    torch_time = (end - start) / 100

    print(f'Triton time: {triton_time*1000:.4f} ms')
    print(f'PyTorch time: {torch_time*1000:.4f} ms')
    print(f'加速比: {torch_time/triton_time:.2f}x')
运行命令:
关键要点:
1. tl.program_id(0) 获取当前 program 的索引
2. tl.arange() 创建偏移量数组
3. mask 处理不能被 BLOCK_SIZE 整除的情况
4. grid 是一个 lambda 函数,返回需要启动的 program 数量
5.2 案例 2:Fused Softmax(中级)
Softmax 是一个常用的操作,但在 PyTorch 中,它实际上是多个操作的组合(max、sub、exp、sum、div)。使用 Triton,我们可以将这些操作融合(fuse)到一个 kernel 中,减少内存访问。
import torch
import triton
import triton.language as tl

@triton.jit
def softmax_kernel(
    output_ptr,
    input_ptr,
    input_row_stride,
    output_row_stride,
    n_cols,
    BLOCK_SIZE: tl.constexpr
):
    # 每个 program 处理一行
    row_idx = tl.program_id(0)

    # 计算当前行的起始指针
    row_start_ptr = input_ptr + row_idx * input_row_stride

    # 列偏移
    col_offsets = tl.arange(0, BLOCK_SIZE)
    input_ptrs = row_start_ptr + col_offsets

    # 加载数据(处理不对齐的情况)
    mask = col_offsets < n_cols
    row = tl.load(input_ptrs, mask=mask, other=-float('inf'))

    # Softmax 计算
    # 步骤 1: 减去最大值(数值稳定性)
    row_minus_max = row - tl.max(row, axis=0)

    # 步骤 2: 计算 exp
    numerator = tl.exp(row_minus_max)

    # 步骤 3: 计算分母(sum)
    denominator = tl.sum(numerator, axis=0)

    # 步骤 4: 除法
    softmax_output = numerator / denominator

    # 存储结果
    output_row_start_ptr = output_ptr + row_idx * output_row_stride
    output_ptrs = output_row_start_ptr + col_offsets
    tl.store(output_ptrs, softmax_output, mask=mask)

def softmax(x: torch.Tensor) -> torch.Tensor:
    n_rows, n_cols = x.shape

    # Block size 必须是 2 的幂,且 >= n_cols
    BLOCK_SIZE = triton.next_power_of_2(n_cols)

    # 分配输出
    y = torch.empty_like(x)

    # 每行一个 program
    num_programs = n_rows

    softmax_kernel[(num_programs,)](
        y,
        x,
        x.stride(0),
        y.stride(0),
        n_cols,
        BLOCK_SIZE=BLOCK_SIZE
    )

    return y

# 测试和 benchmark
if __name__ == '__main__':
    @triton.testing.perf_report(
        triton.testing.Benchmark(
            x_names=['N'],  # 作为 x 轴的参数
            x_vals=[128 * i for i in range(2, 100)],  # 不同的问题规模
            line_arg='provider',  # 用于区分不同实现的参数
            line_vals=['triton', 'torch'],  # 要比较的实现
            line_names=['Triton', 'PyTorch'],  # 图例名称
            styles=[('blue', '-'), ('green', '-')],  # 线条样式
            ylabel='GB/s',  # y 轴标签
            plot_name='softmax-performance',  # 图表名称
            args={'M': 4096},  # 固定参数
        ))
    def benchmark(M, N, provider):
        x = torch.randn(M, N, device='cuda', dtype=torch.float32)
        quantiles = [0.5, 0.2, 0.8]

        if provider == 'torch':
            ms, min_ms, max_ms = triton.testing.do_bench(
                lambda: torch.softmax(x, axis=-1), quantiles=quantiles
            )
        if provider == 'triton':
            ms, min_ms, max_ms = triton.testing.do_bench(
                lambda: softmax(x), quantiles=quantiles
            )

        gbps = lambda ms: 2 * x.nelement() * x.element_size() * 1e-9 / (ms * 1e-3)
        return gbps(ms), gbps(max_ms), gbps(min_ms)

    # 正确性测试
    torch.manual_seed(0)
    x = torch.randn(1823, 781, device='cuda')
    y_triton = softmax(x)
    y_torch = torch.softmax(x, axis=1)

    print(f'最大误差: {torch.max(torch.abs(y_triton - y_torch))}')

    # 运行 benchmark
    benchmark.run(print_data=True, show_plots=True, save_path='.')
运行命令:
关键优化: 1. Kernel Fusion:所有操作在一个 kernel 中完成,减少了内存往返 2. 数值稳定性:减去最大值避免 exp 溢出 3. 向量化:整行数据一次性加载和处理
性能提升: - 相比原生 PyTorch Softmax,Triton 版本通常有 20-40% 的性能提升 - 提升来自于减少了内存访问次数
5.3 案例 3:Layer Normalization(中级)
Layer Normalization 是 Transformer 中的关键组件。
import torch
import triton
import triton.language as tl

@triton.jit
def layer_norm_kernel(
    output_ptr,
    input_ptr,
    weight_ptr,
    bias_ptr,
    input_row_stride,
    output_row_stride,
    n_cols,
    eps,
    BLOCK_SIZE: tl.constexpr
):
    # 每个 program 处理一行
    row_idx = tl.program_id(0)

    # 计算指针
    row_start_ptr = input_ptr + row_idx * input_row_stride
    col_offsets = tl.arange(0, BLOCK_SIZE)
    input_ptrs = row_start_ptr + col_offsets

    # 加载输入
    mask = col_offsets < n_cols
    row = tl.load(input_ptrs, mask=mask, other=0.0)

    # 计算均值
    mean = tl.sum(row, axis=0) / n_cols

    # 计算方差
    centered = row - mean
    variance = tl.sum(centered * centered, axis=0) / n_cols

    # 归一化
    rstd = 1.0 / tl.sqrt(variance + eps)
    normalized = centered * rstd

    # 加载 weight 和 bias
    weight = tl.load(weight_ptr + col_offsets, mask=mask)
    bias = tl.load(bias_ptr + col_offsets, mask=mask)

    # 缩放和平移
    output = normalized * weight + bias

    # 存储结果
    output_row_start_ptr = output_ptr + row_idx * output_row_stride
    output_ptrs = output_row_start_ptr + col_offsets
    tl.store(output_ptrs, output, mask=mask)

def layer_norm(x: torch.Tensor, weight: torch.Tensor, bias: torch.Tensor, eps: float = 1e-5) -> torch.Tensor:
    n_rows, n_cols = x.shape
    BLOCK_SIZE = triton.next_power_of_2(n_cols)

    y = torch.empty_like(x)

    layer_norm_kernel[(n_rows,)](
        y, x, weight, bias,
        x.stride(0),
        y.stride(0),
        n_cols,
        eps,
        BLOCK_SIZE=BLOCK_SIZE
    )

    return y

# 测试
if __name__ == '__main__':
    # 设置
    M, N = 4096, 512
    x = torch.randn(M, N, device='cuda')
    weight = torch.randn(N, device='cuda')
    bias = torch.randn(N, device='cuda')

    # Triton
    y_triton = layer_norm(x, weight, bias)

    # PyTorch
    y_torch = torch.nn.functional.layer_norm(x, (N,), weight, bias)

    # 验证
    print(f'最大误差: {torch.max(torch.abs(y_triton - y_torch))}')

    # Benchmark
    import triton.testing

    ms_triton = triton.testing.do_bench(lambda: layer_norm(x, weight, bias))[0]
    ms_torch = triton.testing.do_bench(lambda: torch.nn.functional.layer_norm(x, (N,), weight, bias))[0]

    print(f'Triton: {ms_triton:.4f} ms')
    print(f'PyTorch: {ms_torch:.4f} ms')
    print(f'加速比: {ms_torch / ms_triton:.2f}x')
5.4 案例 4:Flash Attention(高级)
Flash Attention 是一个革命性的 attention 实现,通过重新组织计算顺序,大幅降低了内存使用。这是 Triton 的杀手级应用。
import torch
import triton
import triton.language as tl

@triton.jit
def flash_attention_kernel(
    Q, K, V, Out,
    stride_qz, stride_qh, stride_qm, stride_qk,
    stride_kz, stride_kh, stride_kn, stride_kk,
    stride_vz, stride_vh, stride_vn, stride_vk,
    stride_oz, stride_oh, stride_om, stride_ok,
    Z, H, M, N, K,
    scale,
    BLOCK_M: tl.constexpr,
    BLOCK_N: tl.constexpr,
    BLOCK_K: tl.constexpr,
):
    # 获取当前处理的 batch 和 head
    batch_idx = tl.program_id(0)
    head_idx = tl.program_id(1)
    block_m = tl.program_id(2)

    # Q 的起始指针
    q_offset = (batch_idx * stride_qz + head_idx * stride_qh)
    Q_block_ptr = Q + q_offset

    # K, V 的起始指针
    kv_offset = (batch_idx * stride_kz + head_idx * stride_kh)
    K_block_ptr = K + kv_offset
    V_block_ptr = V + kv_offset

    # 输出的起始指针
    o_offset = (batch_idx * stride_oz + head_idx * stride_oh)
    O_block_ptr = Out + o_offset

    # 初始化累加器
    offs_m = block_m * BLOCK_M + tl.arange(0, BLOCK_M)
    offs_n = tl.arange(0, BLOCK_N)
    offs_k = tl.arange(0, BLOCK_K)

    # 加载 Q
    q_ptrs = (Q_block_ptr +
              offs_m[:, None] * stride_qm +
              offs_k[None, :] * stride_qk)
    q = tl.load(q_ptrs, mask=offs_m[:, None] < M, other=0.0)

    # 初始化输出累加器
    acc = tl.zeros([BLOCK_M, BLOCK_K], dtype=tl.float32)
    l_i = tl.zeros([BLOCK_M], dtype=tl.float32)
    m_i = tl.full([BLOCK_M], value=-float('inf'), dtype=tl.float32)

    # 循环处理 K 和 V
    for start_n in range(0, N, BLOCK_N):
        # 加载 K
        k_ptrs = (K_block_ptr +
                  (start_n + offs_n[None, :]) * stride_kn +
                  offs_k[:, None] * stride_kk)
        k = tl.load(k_ptrs, mask=(start_n + offs_n[None, :]) < N, other=0.0)

        # 计算注意力分数:QK^T
        qk = tl.dot(q, k)  # [BLOCK_M, BLOCK_N]
        qk *= scale

        # 更新最大值(用于数值稳定性)
        m_ij = tl.max(qk, axis=1)
        m_i_new = tl.maximum(m_i, m_ij)

        # 计算 exp
        alpha = tl.exp(m_i - m_i_new)
        p = tl.exp(qk - m_i_new[:, None])

        # 更新归一化系数
        l_ij = tl.sum(p, axis=1)
        l_i_new = alpha * l_i + l_ij

        # 加载 V
        v_ptrs = (V_block_ptr +
                  (start_n + offs_n[:, None]) * stride_vn +
                  offs_k[None, :] * stride_vk)
        v = tl.load(v_ptrs, mask=(start_n + offs_n[:, None]) < N, other=0.0)

        # 更新累加器
        acc = alpha[:, None] * acc + tl.dot(p.to(v.dtype), v)

        # 更新状态
        l_i = l_i_new
        m_i = m_i_new

    # 最终归一化
    acc = acc / l_i[:, None]

    # 存储输出
    o_ptrs = (O_block_ptr +
              offs_m[:, None] * stride_om +
              offs_k[None, :] * stride_ok)
    tl.store(o_ptrs, acc, mask=offs_m[:, None] < M)

def flash_attention(q: torch.Tensor, k: torch.Tensor, v: torch.Tensor) -> torch.Tensor:
    """
    q, k, v: [batch_size, num_heads, seq_len, head_dim]
    """
    batch_size, num_heads, seq_len, head_dim = q.shape

    # 缩放因子
    scale = 1.0 / (head_dim ** 0.5)

    # 输出
    out = torch.empty_like(q)

    # Block sizes
    BLOCK_M = 64
    BLOCK_N = 64
    BLOCK_K = head_dim

    # Grid
    grid = (batch_size, num_heads, triton.cdiv(seq_len, BLOCK_M))

    flash_attention_kernel[grid](
        q, k, v, out,
        q.stride(0), q.stride(1), q.stride(2), q.stride(3),
        k.stride(0), k.stride(1), k.stride(2), k.stride(3),
        v.stride(0), v.stride(1), v.stride(2), v.stride(3),
        out.stride(0), out.stride(1), out.stride(2), out.stride(3),
        batch_size, num_heads, seq_len, seq_len, head_dim,
        scale,
        BLOCK_M, BLOCK_N, BLOCK_K,
    )

    return out

# 测试
if __name__ == '__main__':
    # 注意:这是一个简化版本,完整的 Flash Attention 还需要处理 causal mask 等

    torch.manual_seed(0)
    batch_size, num_heads, seq_len, head_dim = 2, 8, 512, 64

    q = torch.randn(batch_size, num_heads, seq_len, head_dim, device='cuda')
    k = torch.randn(batch_size, num_heads, seq_len, head_dim, device='cuda')
    v = torch.randn(batch_size, num_heads, seq_len, head_dim, device='cuda')

    # Triton Flash Attention
    out_triton = flash_attention(q, k, v)

    # 标准 Attention(用于验证)
    scale = 1.0 / (head_dim ** 0.5)
    attn = torch.matmul(q, k.transpose(-2, -1)) * scale
    attn = torch.softmax(attn, dim=-1)
    out_torch = torch.matmul(attn, v)

    # 验证
    print(f'最大误差: {torch.max(torch.abs(out_triton - out_torch))}')
    print(f'平均误差: {torch.mean(torch.abs(out_triton - out_torch))}')

    # 内存使用对比
    print(f'\n标准 Attention 内存使用(attention matrix): '
          f'{batch_size * num_heads * seq_len * seq_len * 4 / 1e9:.2f} GB')
    print(f'Flash Attention 内存使用: O(batch_size * num_heads * seq_len * head_dim) - 几乎不需要额外内存')
Flash Attention 的关键创新:
- Tiling:将输入分块,避免实例化完整的 attention matrix
- 重计算:在反向传播时重新计算 softmax,而不是存储
- 内存高效:内存复杂度从 O(N²) 降到 O(N)
性能提升: - 对于 seq_len=2048:~3x 加速,内存使用减少 ~4x - 对于 seq_len=4096:~5x 加速,内存使用减少 ~8x
5.5 案例 5:矩阵乘法(GEMM)(高级)
实现一个高性能的矩阵乘法是 GPU 编程的经典挑战。
import torch
import triton
import triton.language as tl

@triton.jit
def matmul_kernel(
    # 指针
    a_ptr, b_ptr, c_ptr,
    # 矩阵维度
    M, N, K,
    # 步长
    stride_am, stride_ak,
    stride_bk, stride_bn,
    stride_cm, stride_cn,
    # 块大小
    BLOCK_M: tl.constexpr,
    BLOCK_N: tl.constexpr,
    BLOCK_K: tl.constexpr,
    # 激活函数
    ACTIVATION: tl.constexpr,
):
    """
    实现 C = activation(A @ B)
    A: (M, K)
    B: (K, N)
    C: (M, N)
    """
    # 获取 program ID
    pid = tl.program_id(axis=0)
    num_pid_m = tl.cdiv(M, BLOCK_M)
    num_pid_n = tl.cdiv(N, BLOCK_N)

    # 将 pid 映射到 2D grid
    pid_m = pid // num_pid_n
    pid_n = pid % num_pid_n

    # 创建偏移量
    offs_am = pid_m * BLOCK_M + tl.arange(0, BLOCK_M)
    offs_bn = pid_n * BLOCK_N + tl.arange(0, BLOCK_N)
    offs_k = tl.arange(0, BLOCK_K)

    # 初始化指针
    a_ptrs = a_ptr + (offs_am[:, None] * stride_am + offs_k[None, :] * stride_ak)
    b_ptrs = b_ptr + (offs_k[:, None] * stride_bk + offs_bn[None, :] * stride_bn)

    # 初始化累加器
    accumulator = tl.zeros((BLOCK_M, BLOCK_N), dtype=tl.float32)

    # 沿 K 维度循环
    for k in range(0, tl.cdiv(K, BLOCK_K)):
        # 加载 A 和 B 的块
        a = tl.load(a_ptrs, mask=offs_k[None, :] < K - k * BLOCK_K, other=0.0)
        b = tl.load(b_ptrs, mask=offs_k[:, None] < K - k * BLOCK_K, other=0.0)

        # 矩阵乘法
        accumulator += tl.dot(a, b)

        # 更新指针
        a_ptrs += BLOCK_K * stride_ak
        b_ptrs += BLOCK_K * stride_bk

    c = accumulator

    # 应用激活函数
    if ACTIVATION == "relu":
        c = tl.maximum(c, 0)
    elif ACTIVATION == "silu":  # SiLU/Swish
        c = c * tl.sigmoid(c)

    # 存储结果
    offs_cm = pid_m * BLOCK_M + tl.arange(0, BLOCK_M)
    offs_cn = pid_n * BLOCK_N + tl.arange(0, BLOCK_N)
    c_ptrs = c_ptr + (offs_cm[:, None] * stride_cm + offs_cn[None, :] * stride_cn)
    c_mask = (offs_cm[:, None] < M) & (offs_cn[None, :] < N)
    tl.store(c_ptrs, c, mask=c_mask)

def matmul(a: torch.Tensor, b: torch.Tensor, activation: str = "none") -> torch.Tensor:
    """
    计算矩阵乘法并可选地应用激活函数
    """
    assert a.shape[1] == b.shape[0], "维度不兼容"
    assert a.is_contiguous() and b.is_contiguous(), "输入必须是连续的"

    M, K = a.shape
    K, N = b.shape

    # 分配输出
    c = torch.empty((M, N), device=a.device, dtype=a.dtype)

    # 选择块大小(这些值是经过调优的)
    BLOCK_M = 128
    BLOCK_N = 128
    BLOCK_K = 32

    # 启动 kernel
    grid = lambda META: (triton.cdiv(M, META['BLOCK_M']) * triton.cdiv(N, META['BLOCK_N']),)

    matmul_kernel[grid](
        a, b, c,
        M, N, K,
        a.stride(0), a.stride(1),
        b.stride(0), b.stride(1),
        c.stride(0), c.stride(1),
        BLOCK_M, BLOCK_N, BLOCK_K,
        activation,
    )

    return c

# Benchmark
if __name__ == '__main__':
    @triton.testing.perf_report(
        triton.testing.Benchmark(
            x_names=['M', 'N', 'K'],
            x_vals=[128 * i for i in range(2, 33)],
            line_arg='provider',
            line_vals=['cublas', 'triton'],
            line_names=['cuBLAS', 'Triton'],
            styles=[('green', '-'), ('blue', '-')],
            ylabel='TFLOPS',
            plot_name='matmul-performance',
            args={}
        ))
    def benchmark(M, N, K, provider):
        a = torch.randn((M, K), device='cuda', dtype=torch.float16)
        b = torch.randn((K, N), device='cuda', dtype=torch.float16)
        quantiles = [0.5, 0.2, 0.8]

        if provider == 'cublas':
            ms, min_ms, max_ms = triton.testing.do_bench(
                lambda: torch.matmul(a, b), quantiles=quantiles
            )
        if provider == 'triton':
            ms, min_ms, max_ms = triton.testing.do_bench(
                lambda: matmul(a, b), quantiles=quantiles
            )

        # TFLOPS 计算
        perf = lambda ms: 2 * M * N * K * 1e-12 / (ms * 1e-3)
        return perf(ms), perf(max_ms), perf(min_ms)

    # 正确性测试
    torch.manual_seed(0)
    a = torch.randn((512, 512), device='cuda', dtype=torch.float32)
    b = torch.randn((512, 512), device='cuda', dtype=torch.float32)

    triton_output = matmul(a, b)
    torch_output = torch.matmul(a, b)

    print(f'最大误差: {torch.max(torch.abs(triton_output - torch_output))}')

    # 测试 fused activation
    triton_relu = matmul(a, b, activation="relu")
    torch_relu = torch.relu(torch.matmul(a, b))
    print(f'ReLU 最大误差: {torch.max(torch.abs(triton_relu - torch_relu))}')

    # 运行 benchmark
    benchmark.run(print_data=True, show_plots=True)
优化技巧:
- 块大小调优:选择合适的 BLOCK_M、BLOCK_N、BLOCK_K
- Operator Fusion:将激活函数融合到 matmul kernel 中
- 内存访问优化:使用 stride 参数支持非连续内存
六、实用技巧与最佳实践
6.1 调试技巧
6.1.1 打印调试信息
Triton 支持在 kernel 中打印调试信息:
@triton.jit
def debug_kernel(x_ptr, BLOCK_SIZE: tl.constexpr):
    pid = tl.program_id(0)

    # 打印 program ID
    if pid == 0:
        tl.device_print("Program ID:", pid)

    offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
    x = tl.load(x_ptr + offsets)

    # 打印数据
    if pid == 0:
        tl.device_print("First element:", x[0])
6.1.2 使用解释器模式
Triton 提供了解释器模式用于调试:
在解释器模式下,可以: - 设置断点 - 使用 Python 调试器 - 更详细的错误信息
6.1.3 验证正确性
总是与 PyTorch 或 NumPy 的参考实现比较:
def test_correctness():
    x = torch.randn(1024, device='cuda')
    y_triton = my_triton_function(x)
    y_torch = torch_reference(x)

    # 相对误差
    rel_error = torch.abs(y_triton - y_torch) / (torch.abs(y_torch) + 1e-8)
    max_rel_error = torch.max(rel_error)

    print(f'最大相对误差: {max_rel_error}')
    assert max_rel_error < 1e-3, "结果不正确"
6.2 性能优化
6.2.1 选择合适的 Block Size
Block size 对性能影响巨大。一般原则:
# 对于简单的逐元素操作
BLOCK_SIZE = 1024

# 对于矩阵运算
BLOCK_M = 128
BLOCK_N = 128
BLOCK_K = 32  # 较小的 K 有利于寄存器复用

# 使用自动调优
@triton.autotune(
    configs=[
        triton.Config({'BLOCK_M': 128, 'BLOCK_N': 128, 'BLOCK_K': 32}),
        triton.Config({'BLOCK_M': 128, 'BLOCK_N': 256, 'BLOCK_K': 32}),
        triton.Config({'BLOCK_M': 256, 'BLOCK_N': 128, 'BLOCK_K': 32}),
        triton.Config({'BLOCK_M': 256, 'BLOCK_N': 256, 'BLOCK_K': 64}),
    ],
    key=['M', 'N', 'K'],
)
@triton.jit
def optimized_kernel(...):
    pass
6.2.2 内存访问模式
优化内存访问是性能的关键:
# 好的访问模式:连续访问
offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
data = tl.load(ptr + offsets)  # 连续的内存访问

# 不好的访问模式:跨步访问
offsets = pid * BLOCK_SIZE * STRIDE + tl.arange(0, BLOCK_SIZE) * STRIDE
data = tl.load(ptr + offsets)  # 可能导致非合并访问
6.2.3 使用 Tensor Core
对于 FP16 矩阵乘法,确保使用 Tensor Core:
# tl.dot 会自动使用 Tensor Core(如果条件满足)
# 条件:
# 1. 数据类型是 FP16 或 BF16
# 2. 矩阵维度是 16 的倍数
c = tl.dot(a, b)  # a, b 是 FP16

# 可以显式转换
a_fp16 = a.to(tl.float16)
b_fp16 = b.to(tl.float16)
c = tl.dot(a_fp16, b_fp16).to(tl.float32)  # 累加用 FP32
6.2.4 Kernel Fusion
将多个操作融合到一个 kernel 中:
# 不好:多个 kernel
x = input + bias
x = torch.relu(x)
x = x * scale

# 好:融合 kernel
@triton.jit
def fused_add_relu_scale(input_ptr, bias_ptr, output_ptr, scale, ...):
    x = tl.load(input_ptr + offsets)
    bias = tl.load(bias_ptr + offsets)
    x = x + bias
    x = tl.maximum(x, 0)  # ReLU
    x = x * scale
    tl.store(output_ptr + offsets, x)
6.3 与 PyTorch 集成
6.3.1 创建 PyTorch 自定义算子
import torch

class TritonFunction(torch.autograd.Function):
    @staticmethod
    def forward(ctx, x, y):
        # 前向传播
        output = triton_kernel_forward(x, y)

        # 保存反向传播需要的张量
        ctx.save_for_backward(x, y)

        return output

    @staticmethod
    def backward(ctx, grad_output):
        # 反向传播
        x, y = ctx.saved_tensors
        grad_x = triton_kernel_backward_x(grad_output, x, y)
        grad_y = triton_kernel_backward_y(grad_output, x, y)

        return grad_x, grad_y

# 使用
triton_function = TritonFunction.apply
6.3.2 创建 nn.Module
class TritonLayer(torch.nn.Module):
    def __init__(self, in_features, out_features):
        super().__init__()
        self.weight = torch.nn.Parameter(torch.randn(out_features, in_features))
        self.bias = torch.nn.Parameter(torch.randn(out_features))

    def forward(self, x):
        # 使用 Triton kernel
        return triton_linear(x, self.weight, self.bias)
6.4 常见陷阱
6.4.1 边界处理
# 错误:没有 mask
offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
data = tl.load(ptr + offsets)  # 可能越界

# 正确:使用 mask
offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
mask = offsets < n_elements
data = tl.load(ptr + offsets, mask=mask, other=0.0)
6.4.2 数据类型不匹配
# 错误:累加器类型不够
accumulator = tl.zeros((M, N), dtype=tl.float16)  # 可能溢出

# 正确:使用更高精度累加
accumulator = tl.zeros((M, N), dtype=tl.float32)
# ... 计算 ...
result = accumulator.to(tl.float16)  # 最后转换回去
6.4.3 忘记同步
虽然 Triton 会自动处理大部分同步,但在某些情况下需要注意:
七、性能分析与 Profiling
7.1 使用 Triton 内置的 Benchmark
import triton.testing

@triton.testing.perf_report(
    triton.testing.Benchmark(
        x_names=['size'],
        x_vals=[2**i for i in range(12, 20)],
        line_arg='provider',
        line_vals=['triton', 'torch'],
        line_names=['Triton', 'PyTorch'],
        styles=[('blue', '-'), ('green', '-')],
        ylabel='GB/s',
        plot_name='bandwidth-test',
        args={},
    ))
def benchmark(size, provider):
    x = torch.randn(size, device='cuda')
    quantiles = [0.5, 0.2, 0.8]  # 中位数和误差范围

    if provider == 'triton':
        ms, min_ms, max_ms = triton.testing.do_bench(
            lambda: my_triton_kernel(x), quantiles=quantiles
        )
    else:
        ms, min_ms, max_ms = triton.testing.do_bench(
            lambda: torch_reference(x), quantiles=quantiles
        )

    # 计算带宽
    gbps = lambda ms: 2 * size * 4 / (ms * 1e-6) / 1e9
    return gbps(ms), gbps(max_ms), gbps(min_ms)

benchmark.run(print_data=True, show_plots=True)
7.2 使用 NVIDIA Nsight Compute
# 分析 Triton kernel
ncu --set full --target-processes all python my_script.py

# 关注关键指标:
# - Achieved Occupancy(占用率)
# - Memory Throughput(内存带宽)
# - Compute Throughput(计算吞吐量)
# - Warp Execution Efficiency(warp 执行效率)
7.3 使用 PyTorch Profiler
from torch.profiler import profile, record_function, ProfilerActivity

with profile(
    activities=[ProfilerActivity.CPU, ProfilerActivity.CUDA],
    record_shapes=True
) as prof:
    with record_function("triton_kernel"):
        output = my_triton_function(input)

print(prof.key_averages().table(sort_by="cuda_time_total", row_limit=10))

# 导出 Chrome tracing 格式
prof.export_chrome_trace("trace.json")
八、学习路线图
8.1 初级(第1-2周)
目标:理解基本概念,能写简单的 kernel
-
环境搭建
-
学习资源
- 官方教程:https://triton-lang.org/main/getting-started/tutorials/index.html
- 从向量加法开始
-
理解 program_id、arange、load/store
-
练习项目
- 实现向量运算(加、乘、点积)
- 实现简单的激活函数(ReLU、GELU)
- 实现 element-wise 操作
8.2 中级(第3-6周)
目标:掌握常用模式,能优化性能
- 学习内容
- 归约操作(sum、max、min)
- 矩阵操作(转置、矩阵乘法)
- Kernel fusion 技术
-
内存访问优化
-
练习项目
- 实现 Softmax
- 实现 Layer Normalization
- 实现简单的卷积
- 对比 PyTorch 性能
8.3 高级(第7-12周)
目标:能实现复杂算子,达到生产级性能
- 学习内容
- Flash Attention 原理和实现
- 自动调优(autotuning)
- 多维并行策略
-
反向传播的实现
-
练习项目
- 实现 Flash Attention
- 实现自定义 GEMM
- 为 Transformer 实现 fused 算子
- 贡献到开源项目
8.4 专家级(持续学习)
- 深入主题
- Triton 编译器内部
- MLIR 和 IR 优化
- GPU 架构深入理解
-
跨平台优化(NVIDIA + AMD)
-
高级项目
- 实现稀疏计算算子
- 量化和混合精度
- 为新模型架构优化
- 开发 Triton DSL 扩展
九、实用命令与工具
9.1 安装与环境配置
# 基础安装
pip install triton

# 从源码安装(获取最新特性)
git clone https://github.com/openai/triton.git
cd triton/python
pip install -e .

# 安装开发依赖
pip install pytest scipy

# 验证安装
python -c "import triton; print(triton.__version__)"
9.2 常用测试命令
# 运行单个脚本
python my_triton_kernel.py

# 使用特定 GPU
CUDA_VISIBLE_DEVICES=0 python my_script.py

# 性能测试(禁用调试)
TRITON_INTERPRET=0 python benchmark.py

# 查看生成的 PTX 代码
TRITON_PRINT_PTX=1 python my_script.py

# 查看生成的 IR
TRITON_DUMP_IR=1 python my_script.py

# Profiling
nsys profile --stats=true python my_script.py
ncu --set full python my_script.py
9.3 调试命令
# 启用解释器模式(慢但易调试)
TRITON_INTERPRET=1 python my_script.py

# 启用详细日志
TRITON_DEBUG=1 python my_script.py

# 检查编译缓存
ls ~/.triton/cache/

# 清理缓存
rm -rf ~/.triton/cache/*
9.4 Benchmark 模板
创建 benchmark_template.py:
#!/usr/bin/env python3
import torch
import triton
import triton.language as tl

@triton.jit
def my_kernel(...):
    pass

def wrapper(...):
    pass

@triton.testing.perf_report(
    triton.testing.Benchmark(
        x_names=['size'],
        x_vals=[2**i for i in range(10, 20, 1)],
        x_log=True,
        line_arg='provider',
        line_vals=['triton', 'torch'],
        line_names=['Triton', 'PyTorch'],
        styles=[('blue', '-'), ('green', '-')],
        ylabel='GB/s',
        plot_name='my-benchmark',
        args={}
    ))
def benchmark(size, provider):
    # 准备数据
    x = torch.randn(size, device='cuda')

    # Benchmark
    quantiles = [0.5, 0.2, 0.8]
    if provider == 'triton':
        fn = lambda: wrapper(x)
    else:
        fn = lambda: torch_reference(x)

    ms, min_ms, max_ms = triton.testing.do_bench(fn, quantiles=quantiles)

    # 计算性能指标
    gbps = lambda ms: 2 * size * x.element_size() / (ms * 1e-6) / 1e9
    return gbps(ms), gbps(max_ms), gbps(min_ms)

if __name__ == '__main__':
    # 正确性测试
    x = torch.randn(1000, device='cuda')
    y_triton = wrapper(x)
    y_torch = torch_reference(x)
    print(f'Max error: {torch.max(torch.abs(y_triton - y_torch))}')

    # 运行 benchmark
    benchmark.run(show_plots=True, print_data=True)
运行:
十、进阶主题
10.1 多 GPU 支持
import torch.distributed as dist

def multi_gpu_triton():
    # 初始化分布式环境
    dist.init_process_group(backend='nccl')
    rank = dist.get_rank()
    device = torch.device(f'cuda:{rank}')

    # 每个 GPU 运行 Triton kernel
    x = torch.randn(1000, device=device)
    y = my_triton_function(x)

    # 如果需要,可以进行跨 GPU 通信
    dist.all_reduce(y)
10.2 动态形状处理
@triton.jit
def dynamic_kernel(
    x_ptr, y_ptr,
    M, N,  # 运行时才知道的形状
    BLOCK_M: tl.constexpr,
    BLOCK_N: tl.constexpr,
):
    # 根据运行时形状调整
    pid_m = tl.program_id(0)
    pid_n = tl.program_id(1)

    # 动态边界检查
    offs_m = pid_m * BLOCK_M + tl.arange(0, BLOCK_M)
    offs_n = pid_n * BLOCK_N + tl.arange(0, BLOCK_N)
    mask = (offs_m[:, None] < M) & (offs_n[None, :] < N)

    # ...
10.3 自定义 Autotuner
def get_autotune_config():
    configs = []
    for BLOCK_M in [32, 64, 128, 256]:
        for BLOCK_N in [32, 64, 128, 256]:
            for BLOCK_K in [16, 32, 64]:
                for num_stages in [2, 3, 4, 5]:
                    for num_warps in [2, 4, 8]:
                        configs.append(
                            triton.Config(
                                {'BLOCK_M': BLOCK_M, 'BLOCK_N': BLOCK_N, 'BLOCK_K': BLOCK_K},
                                num_stages=num_stages,
                                num_warps=num_warps
                            )
                        )
    return configs

@triton.autotune(
    configs=get_autotune_config(),
    key=['M', 'N', 'K'],
)
@triton.jit
def autotuned_kernel(...):
    pass
10.4 与其他框架集成
JAX 集成
from jax import core
from jax.interpreters import mlir
from jax._src import dispatch

def triton_to_jax(triton_fn):
    def jax_fn(x):
        # 调用 Triton kernel
        return triton_fn(x)

    return jax_fn
TensorFlow 集成
import tensorflow as tf

class TritonOp(tf.Operation):
    def __init__(self, input_tensor):
        super().__init__()
        self.input_tensor = input_tensor

    def forward(self):
        # 转换为 PyTorch tensor
        x_torch = torch.from_numpy(self.input_tensor.numpy())
        # 调用 Triton
        y_torch = my_triton_function(x_torch)
        # 转换回 TensorFlow
        return tf.convert_to_tensor(y_torch.cpu().numpy())
十一、生产环境部署
11.1 性能检查清单
在部署前确保:
- [ ] 正确性测试通过(误差 < 1e-3)
- [ ] 边界情况处理正确
- [ ] 性能达到或超过基准实现
- [ ] 内存使用在预算内
- [ ] 多种输入大小测试通过
- [ ] 在目标 GPU 上测试过
11.2 错误处理
def safe_triton_call(x):
    try:
        # 验证输入
        assert x.is_cuda, "输入必须在 GPU 上"
        assert x.is_contiguous(), "输入必须是连续的"

        # 调用 kernel
        output = my_triton_kernel(x)

        # 验证输出
        assert not torch.isnan(output).any(), "输出包含 NaN"
        assert not torch.isinf(output).any(), "输出包含 Inf"

        return output

    except Exception as e:
        # 降级到 PyTorch 实现
        print(f"Triton kernel 失败: {e},使用 PyTorch 实现")
        return torch_fallback(x)
11.3 版本管理
# 在代码中记录版本信息
TRITON_VERSION = "2.1.0"
KERNEL_VERSION = "1.2.3"

def check_compatibility():
    import triton
    current_version = triton.__version__
    if current_version != TRITON_VERSION:
        print(f"警告:Triton 版本不匹配。期望 {TRITON_VERSION},实际 {current_version}")
十二、常见问题(FAQ)
Q1: Triton 性能为什么有时不如 cuBLAS/cuDNN?
A: cuBLAS 和 cuDNN 是 NVIDIA 花费数年时间高度优化的库,针对特定操作(如 GEMM)进行了极致调优。Triton 的优势在于: 1. 灵活性:可以快速实现自定义算子 2. Fusion:可以融合多个操作 3. 特定场景优化:针对特定输入形状可能更快
Q2: 如何选择 Block Size?
A: 一般原则:
- 从 1024(1D)或 128x128(2D)开始
- 使用 autotuning 找最优值
- 考虑寄存器和共享内存限制
- 使用 triton.cdiv 确保覆盖所有数据
Q3: Triton 支持哪些 GPU?
A: - NVIDIA: Volta (SM70+) 及更新架构 - AMD: CDNA 和 RDNA 架构 - 不支持:Pascal 及更老的架构
Q4: 如何调试 "launch configuration" 错误?
A:
# 检查 grid 配置
num_programs = triton.cdiv(n_elements, BLOCK_SIZE)
print(f"Launching {num_programs} programs")

# 确保至少有一个 program
assert num_programs > 0

# 检查 block 配置是否超限
assert BLOCK_SIZE <= 1024  # CUDA 限制
Q5: 为什么我的 Triton kernel 比 PyTorch 慢?
A: 可能的原因: 1. Block size 不合适 2. 内存访问模式不优 3. 没有充分利用硬件(如 Tensor Core) 4. 启动开销(对小数据) 5. 没有预热 GPU
Q6: Triton 支持 CPU 吗?
A: 不支持。Triton 是专门为 GPU 设计的。如果需要 CPU 支持,使用 PyTorch/NumPy。
十三、学习资源
13.1 官方资源
- 官方文档:https://triton-lang.org/
- GitHub 仓库:https://github.com/openai/triton
- 论文:Triton: An Intermediate Language and Compiler for Tiled Neural Network Computations
13.2 教程和博客
- 官方教程系列:涵盖向量加法到 Flash Attention
- PyTorch 博客:关于 Triton 的文章
- 社区博客:各种优化技巧和案例研究
13.3 示例代码
在 Triton GitHub 仓库中:
13.4 相关项目
- Flash Attention:https://github.com/Dao-AILab/flash-attention
- xFormers:https://github.com/facebookresearch/xformers
- Triton-Puzzles:https://github.com/srush/Triton-Puzzles (练习题)
十四、总结
Triton 代表了 GPU 编程的新方向:
优势: - 🚀 更高的开发效率(代码量减少 80-90%) - 📈 接近手写 CUDA 的性能 - 🔧 更容易维护和扩展 - 🌐 跨平台支持(NVIDIA + AMD) - 🧪 非常适合研究和原型开发
适用场景: - 自定义深度学习算子 - 研究新算法 - Kernel fusion 优化 - 特定领域加速
不适用场景: - 需要极致性能且已有高度优化的库 - CPU 计算 - 需要warp 级精细控制
学习建议: 1. 从简单例子开始(向量加法) 2. 理解核心概念(program、tile、mask) 3. 对比 PyTorch 实现理解优化 4. 逐步尝试复杂算子 5. 阅读 Flash Attention 等经典实现 6. 参与社区,贡献代码
Triton 正在快速发展,是现代 AI 基础设施的重要组成部分。掌握 Triton,你将能够: - 更高效地开发和优化模型 - 实现论文中的新算法 - 为开源项目做贡献 - 在 AI 系统优化领域建立竞争优势
现在就开始你的 Triton 之旅吧!
附录 A:快速参考
常用 API
# Program 控制
tl.program_id(axis)        # 获取 program ID
tl.num_programs(axis)      # 获取 program 总数

# 数据创建
tl.arange(start, end)      # 创建范围
tl.zeros(shape, dtype)     # 全零张量
tl.full(shape, value)      # 常量张量

# 内存操作
tl.load(ptr, mask, other)  # 加载数据
tl.store(ptr, value, mask) # 存储数据

# 数学运算
tl.dot(a, b)              # 矩阵乘法
tl.sum(x, axis)           # 求和
tl.max(x, axis)           # 最大值
tl.exp(x)                 # 指数
tl.log(x)                 # 对数
tl.sqrt(x)                # 平方根

# 原子操作
tl.atomic_add(ptr, val, mask)
tl.atomic_max(ptr, val, mask)
tl.atomic_min(ptr, val, mask)
性能优化检查清单
- [ ] 使用合适的 Block Size
- [ ] 内存访问是连续的
- [ ] 使用 mask 处理边界
- [ ] 对 FP16 矩阵乘法使用 Tensor Core
- [ ] 融合多个操作
- [ ] 使用 FP32 累加器
- [ ] 测试多种输入大小
- [ ] 与基准实现对比
- [ ] 使用 profiling 工具分析
最后更新时间:2025年11月
贡献者:欢迎通过 Pull Request 改进本文档
许可证:本文档采用 CC BY-SA 4.0 许可证